AI-агенты: что это такое и какую проблему они решают
Пользователь редко формулирует задачу нейросети как «напиши текст». Чаще он хочет результат: собрать актуальные факты о рынке, сравнить несколько сервисов по цене и функциям, подготовить черновик статьи и сохранить его в нужном формате — например, таблицей с источниками. Обычный чат с нейросетью отвечает на такой запрос одним развёрнутым сообщением и останавливается. Дальше человек сам открывает вкладки, сверяет цифры, копирует данные в документ и сводит всё вручную.
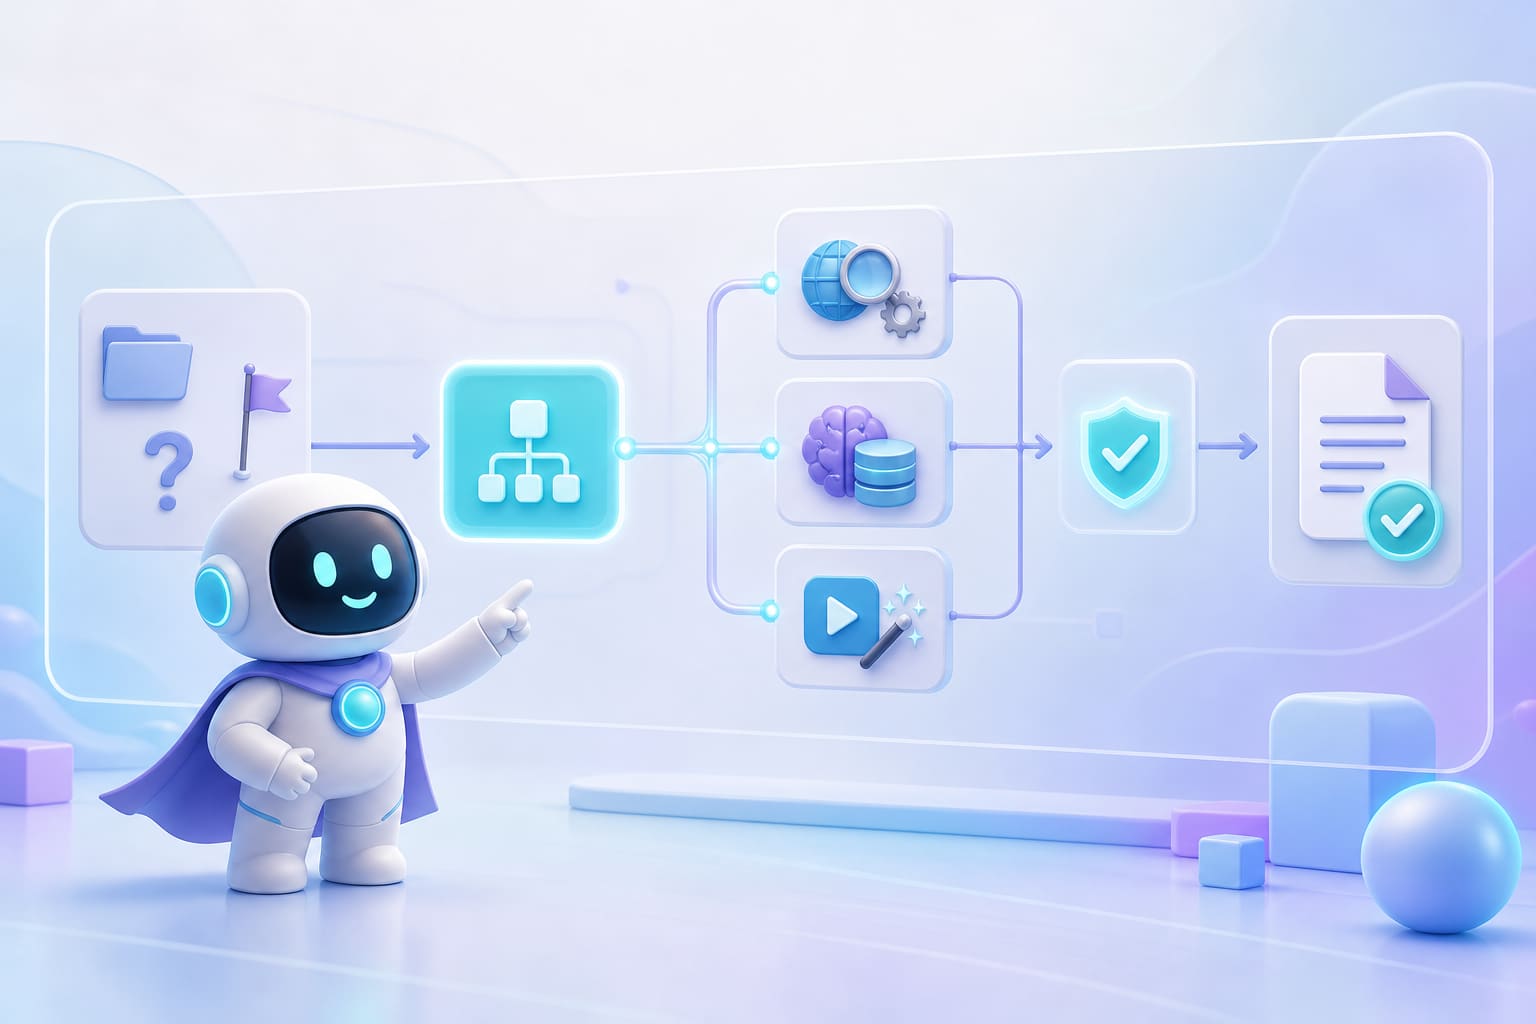
AI-агент устроен иначе. Это программная система, в которой языковая модель получает цель, оценивает контекст задачи, выбирает из доступного набора действий подходящее, обращается к инструментам — поиску, калькулятору, базе данных, API стороннего сервиса — и проверяет промежуточный результат, прежде чем перейти к следующему шагу. Если коротко отвечать на вопрос, что такое ии агент, это не отдельная модель и не навык, а контур: цель → план → действие → проверка → следующий шаг или остановка. Главный объект этой статьи — AI агенты — именно такие контуры, а не красивое название для чат-бота с функцией памяти.
Разница с обычным диалогом видна на простом примере. Пользователь просит «изучи рынок приложений для доставки еды в Москве и предложи три ниши для нового сервиса». Чат отвечает одним текстом на основе того, что модель уже «знает» из обучения, а эти сведения могут быть устаревшими на год и больше. Агент с той же целью сначала уточняет период и регион, обращается к поиску за свежими данными, собирает несколько источников, сверяет цифры между собой, формирует таблицу ниш с аргументами и только после этого отдаёт результат на проверку. Разница не в «уме» модели, а в наличии цикла: агент может разбить задачу на шаги, вызвать внешний инструмент, обработать файл, обратиться к API и продолжить выполнение там, где обычный чат просто закончил бы ответ.
Второй пример — генерация контента для рекламной кампании. В режиме чата запрос «напиши пять заголовков для акции» даёт пять вариантов и ждёт следующей команды. Агент с той же целью может сначала проверить, какие заголовки уже использовались в прошлых кампаниях бренда, если ему открыт доступ к архиву, отсеять повторы, сгенерировать варианты под разные сегменты аудитории, проверить длину под конкретную рекламную площадку и собрать итог в готовый файл. Слово «агенты» описывает здесь не маркетинговый ярлык, а конкретное техническое поведение: самостоятельный выбор следующего действия в рамках заданных правил.
Важно не обещать того, чего система не умеет. Агент действует только в пределах выданных ему полномочий, качества входных данных и набора подключённых инструментов. Если у агента нет доступа к свежему поиску, он не узнает о событии, случившемся вчера. Если входные данные в документе противоречивы, агент либо повторит противоречие, либо остановится и запросит уточнение — в зависимости от настроек. Автономные системы такого рода не заменяют контроль, они его перераспределяют: часть рутинных решений модель берёт на себя, финальную проверку и ответственность оставляет человеку.
Возражение «это просто красивое название для чат-бота» снимается конкретикой. Обычный чат не вызывает поиск самостоятельно в рамках одного запроса, не читает прикреплённый файл построчно с извлечением таблицы, не обращается к внешнему API, чтобы получить курс валют или статус заказа, и не продолжает работу после первого ответа без нового сообщения. AI-агент делает именно это — переходит от одного шага к другому без необходимости каждый раз получать команду от человека, пока не достигнет цели или не упрётся в ограничение. Для пользователя в России, который выбирает инструмент под конкретную задачу — отчёт, сравнение сервисов, сборка контента, — это отличие определяет, нужен ли вообще агентный сценарий или достаточно одного развёрнутого запроса к модели.
Технически это описано и в документации крупных провайдеров: материал про инструменты и вызовы функций в API показывает, что модель на каждом шаге решает, ответить текстом или вызвать доступный инструмент — поиск, функцию, обработку файла, — и это решение принимается автоматически, без ручной команды на каждый вызов. Устройство агентных функций на практике можно изучить в разделе AI-агенты ModelStation — ModelStation, а более широкий контекст о памяти, моделях и агентных сценариях собран в материале Понятно о моделях, памяти и агентах — ModelStation.
Из чего состоит система ИИ-агентов
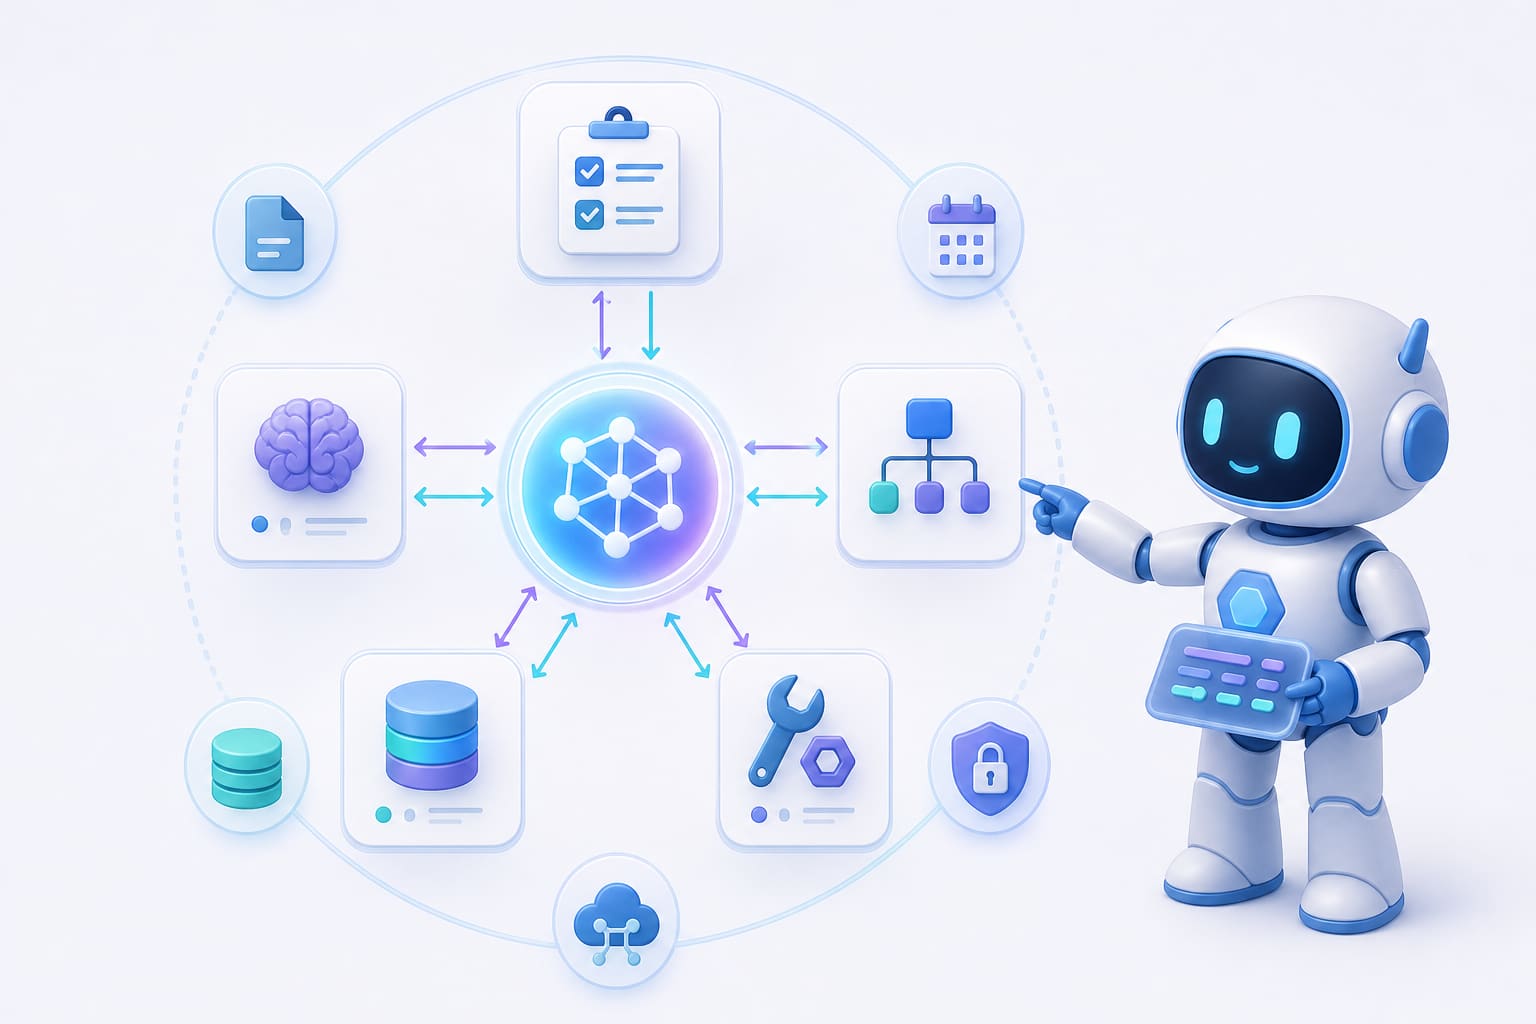
За словом «агент» не стоит магия — это набор связанных модулей, и каждый отвечает за свою часть работы. Разбор по компонентам снимает ощущение чёрного ящика и объясняет, почему два агента на одной и той же модели могут давать совершенно разный результат.
Языковая модель — это механизм интерпретации и генерации: она читает цель и контекст, предсказывает наиболее вероятное продолжение и формирует текст, код или аргументы для вызова инструмента. Системные инструкции — это правила поведения: что агенту разрешено делать, в каком тоне отвечать, какие источники считать приоритетными, когда останавливаться. Память — источник контекста: что уже обсуждалось, какие решения приняты, какой стиль задан. Инструменты — каналы воздействия на внешний мир: поиск, калькулятор, база данных, генератор изображений, почтовый сервис. Оркестратор — слой, который управляет последовательностью вызовов: решает, какой компонент активировать следующим, передаёт результат одного шага на вход другому и останавливает цепочку при сбое или достижении цели. Так устроена система ии агентов на базовом уровне, и именно сочетание этих пяти частей отличает автономное поведение от одного запроса к модели.
Качество результата зависит не только от силы модели. Можно подключить самую современную модель и получить слабый результат, если инструмент вызова поиска возвращает нерелевантные страницы, если у агента нет прав на чтение нужной папки, или если входные данные в таблице не структурированы и перепутаны местами столбцы. В этом смысле вопрос «как работают автономные системы» правильнее задавать не про модель саму по себе, а про всю цепочку: модель плюс инструкции плюс права плюс данные плюс оркестрация. Слабое звено в любом из этих мест портит результат даже при безупречном ядре.
Пример из редакционной практики показывает всю цепочку целиком. Агент получает тему: «подготовить материал о налоговых изменениях для малого бизнеса». Дальше он ищет подтверждённые сведения в нескольких источниках, сопоставляет формулировки, составляет план с подзаголовками, пишет черновик по плану, прогоняет проверку фактов по ключевым цифрам и передаёт готовый текст редактору вместе со списком источников. Каждый шаг — отдельный вызов модели с разным набором инструкций: на этапе поиска агенту важна полнота и свежесть, на этапе написания — стиль и связность, на этапе проверки — точность и соответствие источникам.
Многоагентная схема, где исследователь, автор и проверяющий — это отдельные роли с собственными инструкциями, нужна не всегда. Она повышает управляемость: проще найти, на каком шаге возникла ошибка, легче настраивать поведение каждой роли отдельно. Но у неё есть цена — больше вызовов модели, сложнее передавать контекст между ролями, выше суммарная стоимость и больше точек, где цепочка может застрять. Для несложной задачи с одним понятным результатом один агент с чётким набором инструкций работает надёжнее и дешевле, чем три специализированные роли.
Российский контекст добавляет практический нюанс: не все облачные агентные платформы одинаково доступны и стабильны для пользователей из Москвы и Санкт-Петербурга, поэтому выбор инструментов внутри системы ии агентов часто определяется не только техническими возможностями, но и доступностью конкретных моделей и сервисов на российском рынке. Подробнее о подборе моделей под задачу рассказано в материале Как выбрать лучшую AI модель и не переплачивать? Зачем нужны агрегаторы нейросетей? — ModelStation, а сравнение моделей по направлениям — в разделе Какие нейросети лучшие для текста, генерации фото, видео и музыки — ModelStation. Официальная документация о производственных агентных системах, их жизненном цикле и масштабировании собрана в документации Google Cloud по агентным системам — там видно, что речь идёт именно об инженерной архитектуре, а не об одной «умной» модели.
Как агент планирует задачу и выбирает действие
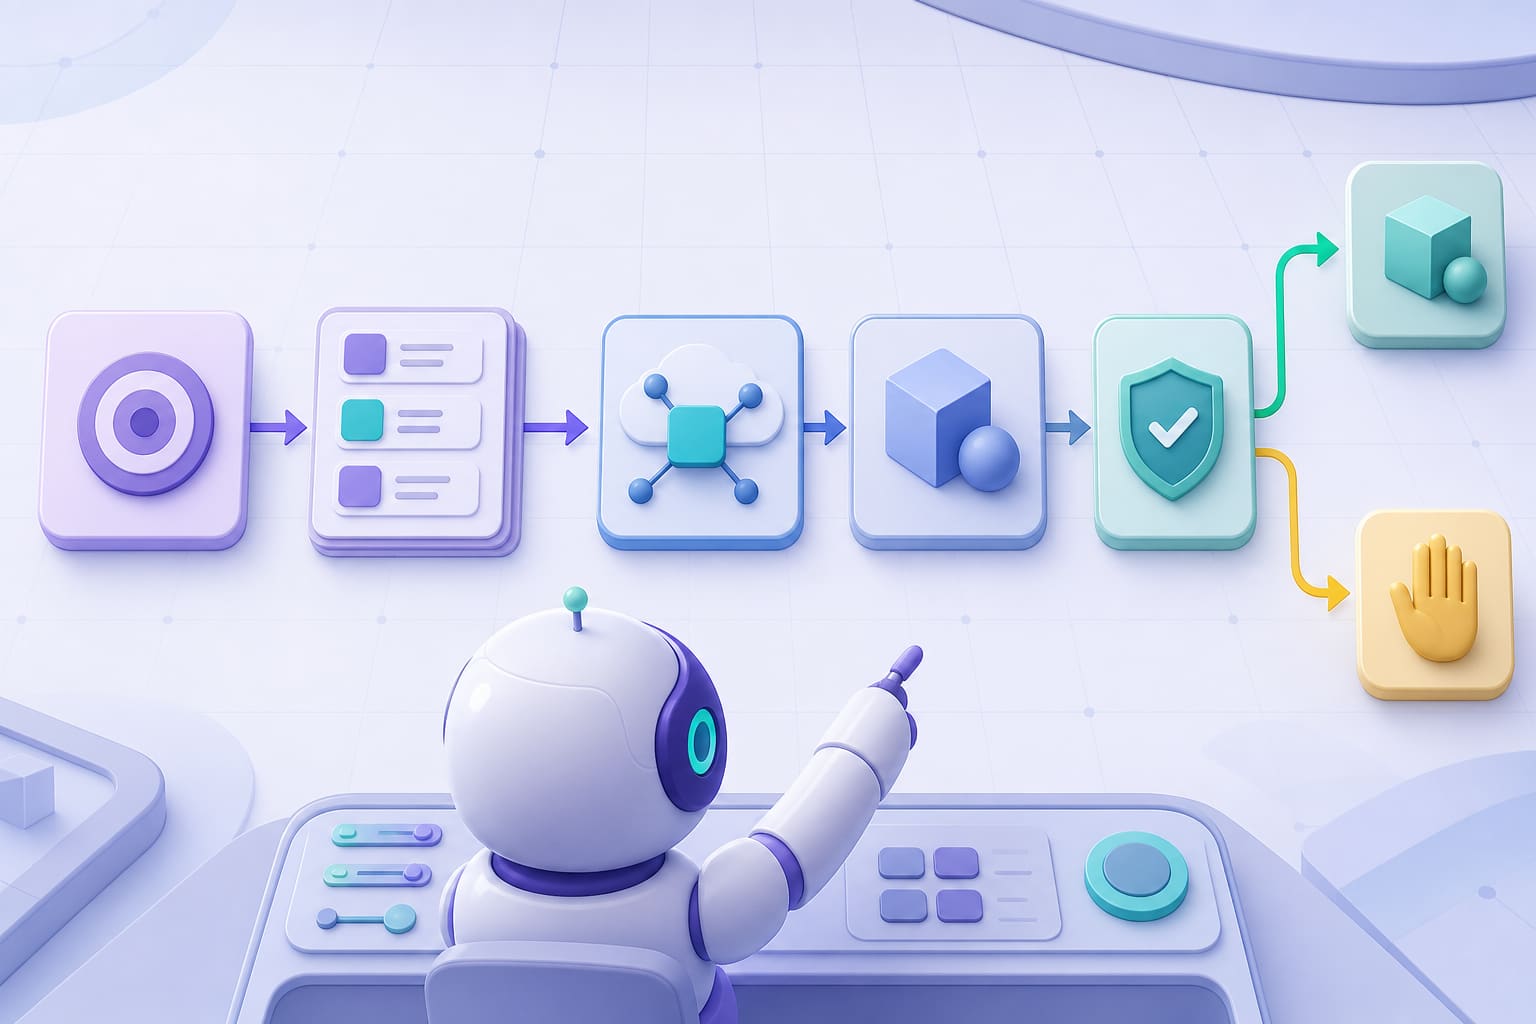
Рабочий цикл агента удобно разобрать на одном сквозном сценарии. Предприниматель просит подготовить сравнительный обзор сервисов для контент-команды: нужно сопоставить три-четыре инструмента по функциям, цене и удобству для копирайтеров и дизайнеров.
Первый шаг — агент уточняет цель и ограничения: какие именно сервисы сравнивать, по каким критериям, в каком формате нужен итог — таблица, список плюсов и минусов, рекомендация. Второй шаг — формирование плана: собрать функциональные характеристики каждого сервиса, найти актуальные цены, проверить отзывы пользователей, свести всё в сравнительную структуру. Третий шаг — определение недостающих данных: если агенту неизвестны текущие цены, он вызывает поиск или обращается к базе знаний. Четвёртый шаг — сопоставление сведений: агент сверяет цифры из разных источников, помечает расхождения. Пятый шаг — создание черновика сравнения. Шестой шаг — проверка: соответствуют ли цифры в тексте тем, что были найдены на предыдущем шаге, нет ли противоречий. Это и есть практический пример того, как работает связка ai ии агент на уровне одного сценария — не один большой ответ, а последовательность проверяемых операций.
Планирование, рассуждение и выполнение — разные вещи, и их полезно не путать. План задаёт порядок шагов: сначала собрать данные, потом сравнить, потом написать. Рассуждение — это то, что помогает агенту выбрать следующий шаг здесь и сейчас: например, решить, что цена важнее функций для данной аудитории, или заметить, что данных по одному сервису не хватает и нужно вернуться на шаг поиска. Инструмент — это то, что фактически выполняет операцию: обращается к внешнему API, читает файл, считает сумму. Без разделения этих трёх уровней сложно понять, почему агент иногда «зависает» на одном шаге или возвращается назад: он не застрял, а перепланирует маршрут на основе новой информации.
Агент может остановиться по нескольким причинам: не хватает данных для продолжения, инструмент вернул ошибку, или задача подразумевает решение с высокой ценой ошибки — например, отправку письма клиенту или списание средств. В таких случаях система должна запросить уточнение у пользователя или передать финальное решение человеку, а не продолжать цепочку наугад. Лимиты шагов, тайм-ауты на каждый вызов, обязательное подтверждение рискованных операций и журнал действий — это не опциональные настройки, а базовая гигиена агентного сценария. Без лимита шагов агент теоретически способен зациклиться, повторяя один и тот же неудачный вызов инструмента; без журнала невозможно разобраться, на каком шаге цепочка пошла не так.
Возражение «автономность означает бесконтрольность» снимается простым правилом: чем выше цена ошибки, тем больше ручных подтверждений нужно встроить в маршрут. Сравнение сервисов для контент-команды — низкий риск, можно дать агенту почти полную свободу действий внутри сбора и сопоставления данных. А вот отправка готового сравнения клиенту от имени компании — уже другой уровень, здесь нужна пауза и проверка человеком перед публикацией. Автономные агенты не отменяют контроль, они делают его точечным: не на каждом шаге, а там, где ошибка стоит дорого.
Официальный материал Microsoft про описание планирования, памяти и вызова инструментов подтверждает, что способность агентного сервиса рассуждать, планировать и обращаться к инструментам — это задокументированная часть архитектуры, а не маркетинговое обещание. Разобраться, как выбрать конкретный ИИ-инструмент под задачу вроде сравнения сервисов, помогает материал Все про нейросети: как выбрать ИИ-инструмент онлайн.
Память и контекст: что агент помнит о задаче
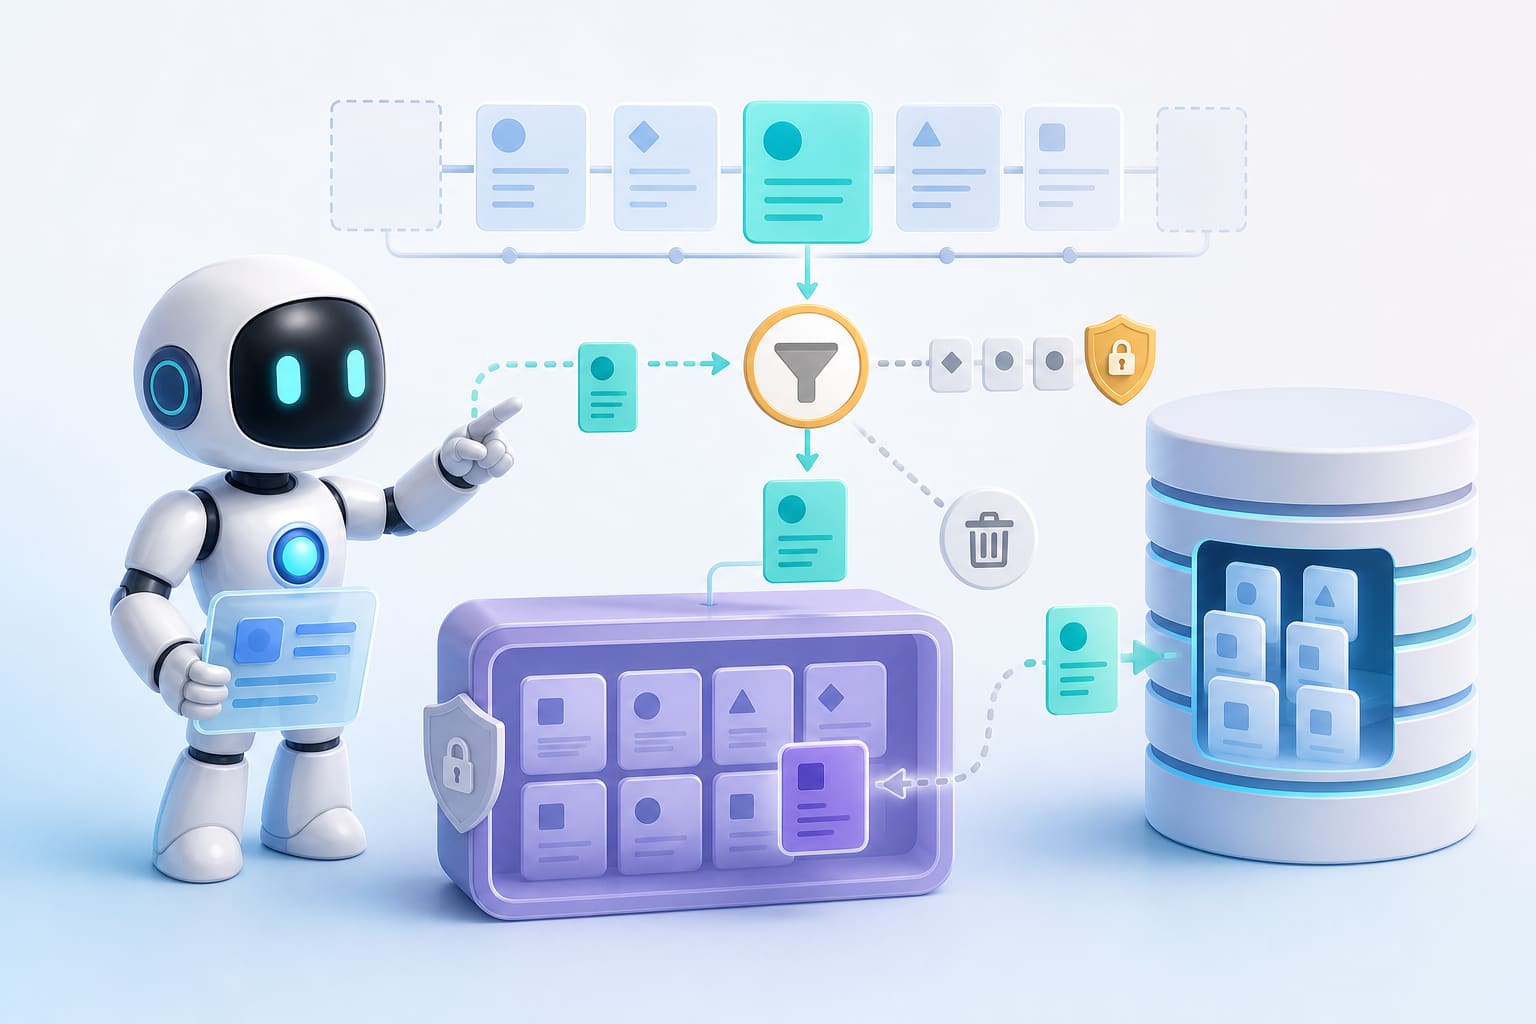
Представим бытовую ситуацию: пользователь возвращается к проекту через неделю. Он ждёт, что агент помнит цель, принятый стиль изложения, уже согласованные ограничения — например, что материалы нужны без канцелярита и с акцентом на малый бизнес. Но агент не обязан помнить вообще всё: лишние детали прошлых разговоров, случайные уточнения, черновики, которые были отменены, — всё это не нужно таскать в каждый новый запрос.
Память агента удобно делить на три уровня. Краткосрочный контекст диалога — то, что происходит в рамках текущей сессии: последние сообщения, промежуточные результаты, актуальный план. Долговременные заметки — устойчивые факты о проекте: стиль, ограничения, принятые ранее решения, которые должны сохраняться между сессиями. Внешнее хранилище знаний — база документов, таблиц, инструкций, к которой агент обращается по запросу, не держа всё содержимое в активном контексте. Автономные ии агенты, которые работают над длительными проектами, обычно используют все три уровня одновременно, но с разными правилами доступа и сроком жизни данных.
Память напрямую влияет на три вещи: персонализацию — агент учитывает стиль и предпочтения конкретного пользователя без повторных объяснений; повторяемость результата — похожие задачи решаются похожим образом, а не каждый раз с нуля; экономию времени — не нужно заново формулировать ограничения проекта. Но у избыточной памяти есть обратная сторона. Чем больше контекста агент тянет в каждый запрос, тем дороже обработка — модель оплачивается за объём входных данных, и лишние абзацы увеличивают счёт без пользы. Хуже того, в памяти накапливаются устаревшие инструкции: правило, актуальное месяц назад, может противоречить новому решению, и агент не всегда способен понять, какое из двух указаний действует сейчас.
Правила жизненного цикла памяти должны отвечать на пять вопросов. Что сохраняется: факты, решения, ограничения — а не случайные реплики. Кто может читать: сам пользователь, команда проекта или только агент. Как исправляются ошибки: через явное обновление записи, а не молчаливое добавление новой поверх старой. Когда сведения удаляются: по сроку, по завершении проекта или по явному запросу пользователя. Как отделяются пользовательские данные от общих знаний: персональная информация клиента не должна смешиваться с общей базой знаний компании, иначе один проект начнёт «подсказывать» агенту сведения из другого.
Отдельный риск — «ложная память», когда агент принимает предположение за факт и закрепляет его как установленное решение. Например, на одном из этапов агент предположил, что дедлайн проекта — конец месяца, хотя пользователь этого не говорил явно, а затем сохранил это предположение как факт и использовал в дальнейших расчётах. Без механизма проверки такие ложные записи накапливаются и постепенно искажают работу. Снять возражение «чем больше памяти, тем умнее система» просто: умнее систему делает не объём сохранённого, а качество, актуальность и управляемость данных — десять точных и проверенных фактов полезнее тысячи строк случайных заметок.
Официальная документация Google про память, сессии и управление агентами описывает именно такую управляемую инфраструктуру: отдельные сессии, явные правила хранения и наблюдаемость того, что агент помнит и откуда это взял.
Инструменты, интеграции и границы полномочий
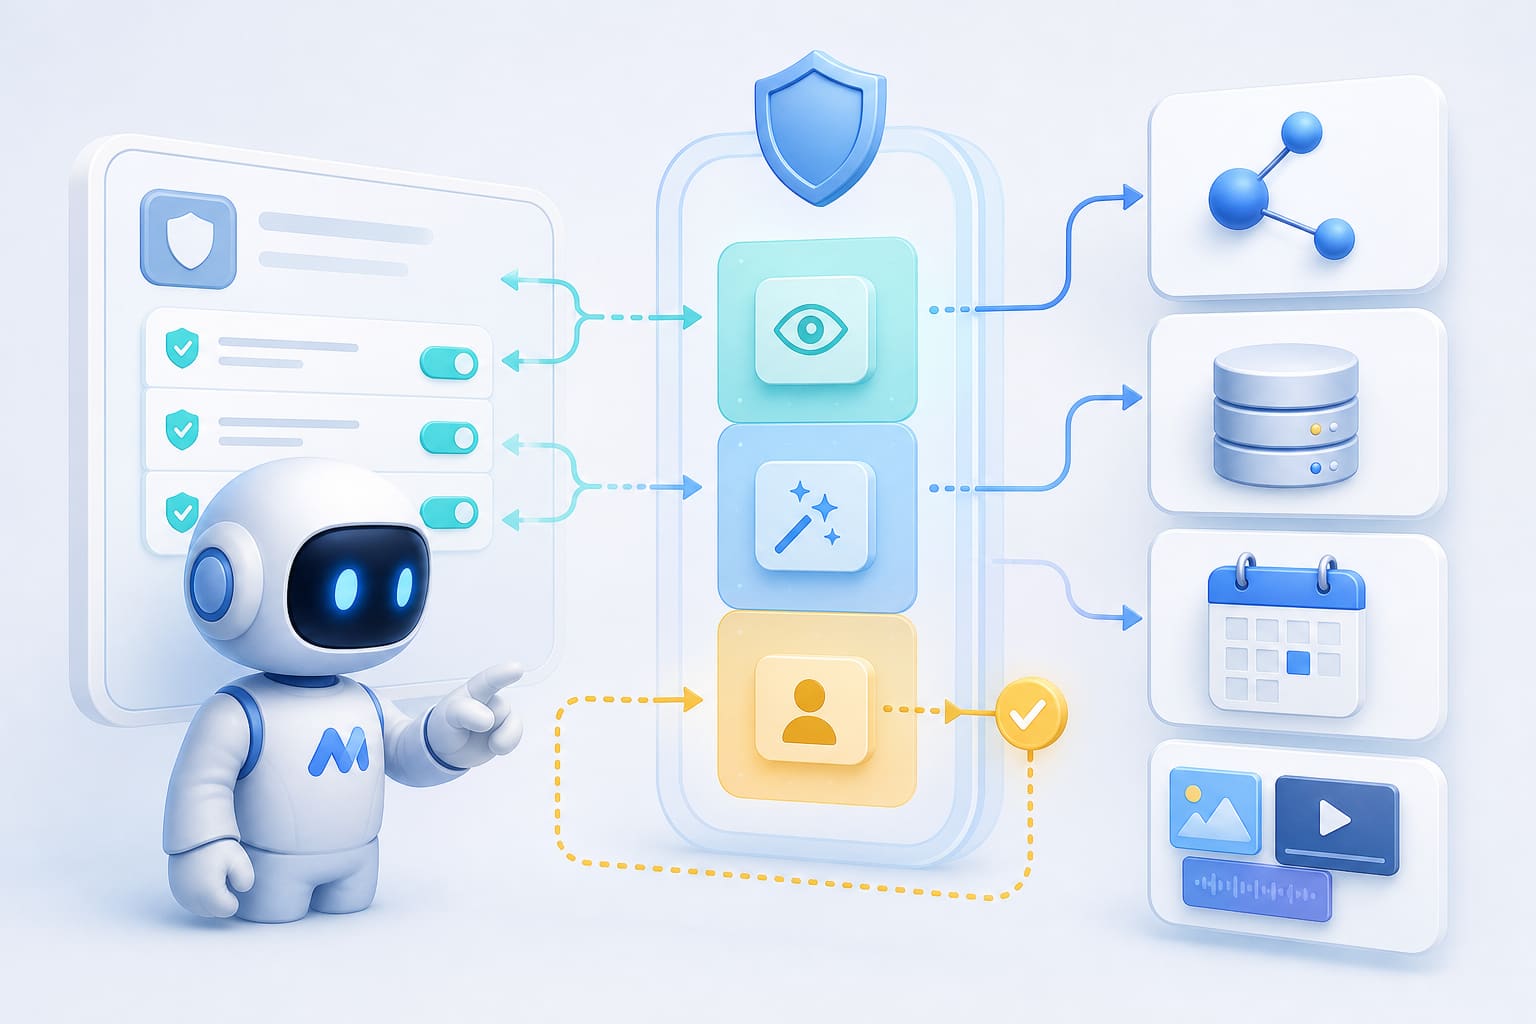
Агент становится полезным не в момент выбора модели, а в момент подключения инструментов. Без доступа к поиску, документам, таблицам, календарю, CRM, генераторам изображений, коду, внутренним базам и API агент — это просто модель, которая красиво рассуждает, но не может ничего сделать за пределами текста. Инструменты — это то, что превращает рассуждение в действие.
Первое, что стоит различать, — чтение и изменение данных. Получить сведения из базы заказов безопаснее, чем изменить статус заказа. Прочитать переписку с клиентом безопаснее, чем отправить от его имени письмо. Посмотреть баланс счёта безопаснее, чем провести платёж. Ии агенты в россии, которые подключают к рабочим процессам компании, должны с самого начала разделять эти два типа операций: чтение почти всегда можно доверить агенту широко, запись — только точечно и с дополнительной проверкой.
Модель разрешений строится на нескольких принципах. Белый список инструментов — агенту доступны только явно перечисленные функции, а не произвольный вызов любого API. Отдельные права на чтение и запись — даже для одного и того же источника данных это разные уровни доступа. Ограничение по пользователю, проекту и времени — агент, настроенный для одного клиента, не должен автоматически иметь доступ к данным другого; права, выданные на один проект, не переносятся на соседний без явного решения. Подтверждение необратимых действий — отправка письма, удаление файла, списание средств проходят через дополнительный шаг, где человек соглашается или отклоняет операцию.
Пример контентного процесса показывает эти правила в деле. В сценарии ModelStation агент может собрать бриф на основе исходных материалов, сравнить ответы нескольких текстовых моделей на один и тот же промпт, подготовить изображение или черновик видео под задачу. Но публикация готового материала в соцсети и расходование рекламного бюджета на продвижение — это отдельные действия, которые должны оставаться вне автоматического контура генерации, с обязательным решением человека на выходе. Генерация контента и его распространение — разные уровни риска, и смешивать их в одном бесконтрольном потоке не стоит.
Интеграция через API добавляет техническую сторону вопроса. Любой внешний вызов требует журналирования — записи, что, когда и с каким результатом было вызвано; обработки ошибок — что делать, если сервис недоступен или вернул неожиданный формат; повторных попыток с ограничением по числу, чтобы сбой на одном шаге не превратился в бесконечный цикл; и защиты ключей доступа — они не должны оказаться внутри промпта или в логах, которые может прочитать посторонний.
Возражение «подключить всё сразу быстрее» не выдерживает проверки практикой. Каждый дополнительный инструмент — это дополнительная поверхность риска: ещё один способ, которым агент может ошибиться, ещё одно место, где нужно проверять права доступа, и ещё один узел, который нужно диагностировать при сбое. Пять хорошо описанных инструментов с понятными ограничениями работают надёжнее, чем пятнадцать подключений «на всякий случай», из которых используется три. Официальная документация Microsoft про управляемые инструменты и жизненный цикл агента описывает именно такую модель: версии инструментов, политики доступа и наблюдаемость каждого вызова. Практические примеры подключения генераторов изображений к рабочим сценариям собраны в материалах Изображения, которые работают на вашу идею — ModelStation и Как использовать нейросети для генерации фото и картинок? — ModelStation.
Какие задачи AI-агенты решают на практике
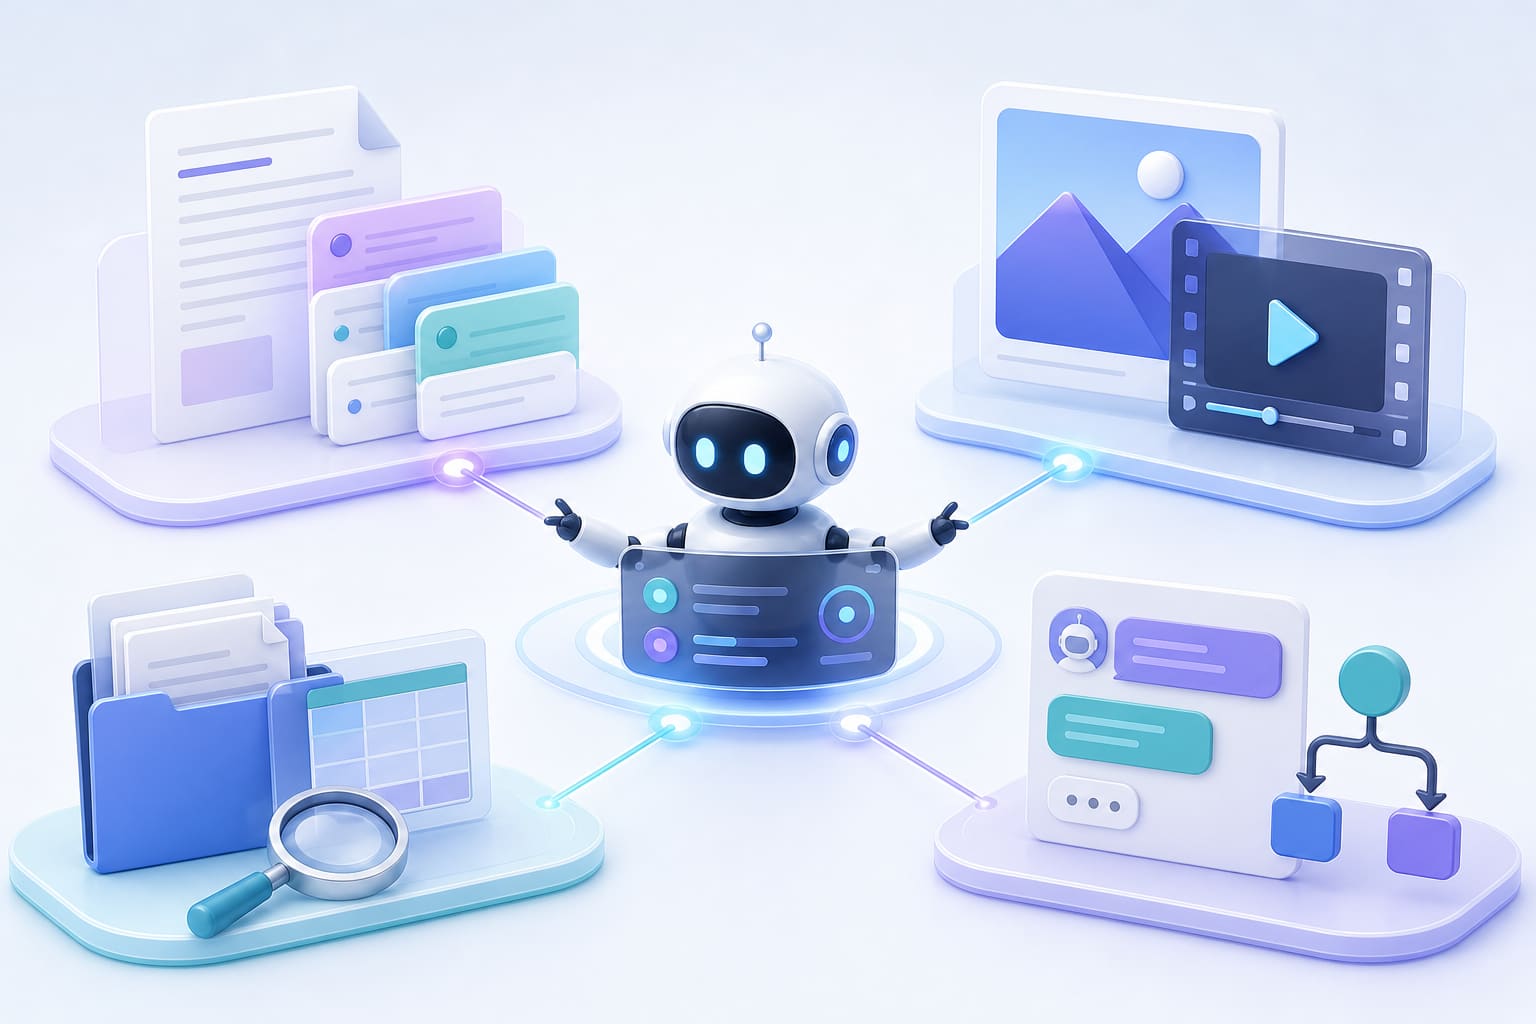
Сценарии применения удобнее группировать не по модным названиям, а по типу результата, который получает пользователь на выходе.
Для контент-команды цепочка выглядит так: бриф с целью и ограничениями → текстовый черновик → изображение или обложка под публикацию → при необходимости видео или музыкальное сопровождение. Каждый шаг может выполнять отдельная модель внутри одного контура, а агент связывает их между собой, следя за тем, чтобы стиль и смысл не терялись при переходе от текста к визуалу. Для специалиста, который работает с большим объёмом входящей информации, агент полезен в сборе данных из нескольких источников, извлечении конкретных фактов из документов — дат, сумм, условий договора, — подготовке короткой сводки по итогам дня и контроле дедлайнов по открытым задачам.
Для бизнеса типовой набор задач — это квалификация входящих обращений: агент читает сообщение клиента, определяет тему и приоритет, формирует первичный ответ по шаблону и направляет обращение нужному специалисту, если вопрос выходит за рамки стандартного сценария. Сюда же относится подготовка регулярного отчёта: агент собирает цифры из нескольких систем, сводит их в единый формат и готовит черновик для менеджера, который проверяет и утверждает итоговую версию. Для разработчика агент может искать нужный фрагмент в документации, предлагать черновик кода по описанию задачи, прогонять базовые тесты и формировать описание внесённых изменений для ревью.
AI агенты действительно экономят время там, где процесс повторяется: похожая задача решается снова и снова, занимает заметное время при ручном выполнении, у неё есть понятный измеримый результат, и источники данных для неё доступны агенту технически. Пример: обработка сотни однотипных обращений в поддержку в месяц — хороший кандидат на автоматизацию, потому что задача повторяется, занимает часы ручного труда и легко проверяется по факту закрытия обращения.
Есть области, где агент не заменяет эксперта и не должен пытаться это делать. Юридическое заключение требует квалифицированной ответственности конкретного специалиста, а не текста, сгенерированного по шаблону. Медицинское решение касается здоровья человека и не может приниматься автоматически. Финансовая операция с реальными деньгами клиента требует явного подтверждения человеком. Публикация материала без редактора создаёт риск репутационных ошибок, которые дешевле предотвратить, чем исправлять постфактум. Действия с критической инфраструктурой — отключение сервиса, изменение конфигурации продакшена — должны оставаться в руках ответственного инженера. Это тот же принцип, что звучал ранее: как работают автономные системы — в рамках заданных полномочий, а не вместо экспертной ответственности.
Возражение «агент нужен каждому» снимается простым критерием окупаемости. Задача стоит автоматизировать агентом, если она повторяется регулярно, занимает заметное время сотрудника, имеет измеримый результат и допускает проверку — то есть можно сравнить, что сделал агент, с тем, что сделал бы человек, и увидеть разницу в качестве или скорости. Единичная нестандартная задача, которая случается раз в квартал, обычно не окупает настройку агентного сценария.
Официальная площадка для работы с моделями и инструментами подтверждает, что перечисленные сценарии опираются на реально существующие API и инструменты, а не на предположения о будущих возможностях. Практические примеры подготовки видео собраны в материале Как использовать нейросети для создания ИИ-видео? Какие из них лучшие? — ModelStation, а сценарии создания музыкального сопровождения — в разделах Музыка/Песни — ModelStation и Генерация музыки и песен с помощью искусственного интеллекта: как создать песню с помощью ИИ?.
AI-агенты в бизнесе: эффективность, контроль и измеримый результат
Внедрение агентного сценария в компании устроено как управленческий проект, а не как покупка одной кнопки «включить автоматизацию». Начинать стоит с карты процесса: какие данные поступают на входе, какие шаги повторяются от случая к случаю, в каких точках нужно ручное решение, сколько стоит ошибка на этом процессе и какой результат ожидается на выходе.
Пилотный запуск AI агенты проходят не вслепую, а под конкретные показатели. Время выполнения задачи агентом в сравнении с ручной работой. Доля задач, которые были приняты без исправлений со стороны человека. Количество обращений к человеку за уточнением на сто запусков. Стоимость одного результата — сколько стоит обработка одного обращения или подготовка одного отчёта. Процент ошибок, которые заметил проверяющий. Соблюдение SLA — укладывается ли агент в срок, который требуется бизнесу.
Последовательность внедрения имеет смысл соблюдать в таком порядке. Выбрать один узкий процесс, а не пытаться автоматизировать сразу весь отдел. Описать правила: что агент делает самостоятельно, что предлагает на утверждение, что ему запрещено. Подключить минимальный набор инструментов — ровно столько, сколько нужно для выбранного процесса, не больше. Провести тесты на реальных данных прошлых периодов и на искусственно созданных сложных случаях. Сравнить результат с тем, что получалось при ручной работе, по тем же метрикам. И только затем постепенно расширять полномочия агента — на соседние процессы или на более рискованные операции внутри того же процесса.
Организационная сторона внедрения не менее важна, чем техническая. У процесса должен быть владелец — конкретный сотрудник, который отвечает за то, что происходит внутри этого участка работы. Кто-то должен утверждать инструкции агента и их изменения, а не оставлять это на усмотрение разработчика или подрядчика. Нужен человек, который получает уведомление о сбое в реальном времени, а не узнаёт о нём из жалобы клиента неделю спустя. И отдельно должно быть зафиксировано, кто отвечает за финальный результат перед руководством — сама система или владелец процесса, который её настроил и контролирует.
Возражение «нужен большой бюджет и команда разработчиков» снимается сценарием постепенного запуска. Начать можно в агрегаторе моделей, где доступно сразу несколько текстовых и генеративных моделей без необходимости заключать отдельный договор с каждым провайдером и разворачивать собственную инфраструктуру. На этом этапе задача — не построить production-систему, а проверить гипотезу: действительно ли агентный сценарий экономит время на конкретном процессе и какого качества результат получается. Условия тарифов можно сверить в разделе Тариф — ModelStation, а общее представление о платформе — в материале О ModelStation — ModelStation.
Официальный хаб Microsoft, описывающий подход к планированию, внедрению и управлению агентами, разделяет внедрение именно на эти этапы — планирование, внедрение, принятие командой, управление и постепенное улучшение — что подтверждает: агентные проекты в компаниях строятся по общей методологии, а не по наитию конкретного отдела.
Безопасность, приватность и российский контекст
До того как агенту передают рабочие данные, стоит получить ответы на несколько конкретных вопросов. Где физически обрабатывается информация — на серверах какого провайдера и в какой юрисдикции. Кто имеет доступ к данным внутри самого сервиса — только модель на время обработки запроса или ещё и команда поддержки провайдера. Какие журналы действий ведутся и можно ли их выгрузить для разбора инцидента. Как удаляются сведения по запросу пользователя. Какие внешние сервисы агент вызывает в рамках своей работы. И можно ли отключить использование пользовательских данных для дообучения модели провайдера.
В России при работе с персональными данными нужно учитывать требования 152-ФЗ и обязанности оператора персональных данных: прежде чем агент начинает обрабатывать данные клиентов или сотрудников, компания должна определить цель обработки, получить согласие там, где это требуется, и обеспечить разграничение доступа внутри своей инфраструктуры. Для корпоративных процессов добавляются внутренние политики безопасности, условия договора с провайдером сервиса и правила разграничения доступа между отделами. Это не юридическое заключение и не замена консультации с юристом по конкретному кейсу — это перечень вопросов, которые нужно закрыть до запуска, а не после инцидента.
У агентных систем есть специфические угрозы, которых не было у обычных форм и чат-ботов с фиксированным сценарием. Утечка через промпт или память — если агент случайно включает в ответ фрагмент чужих данных, сохранённых ранее в общей памяти. Вредоносная инструкция, спрятанная в документе, который агент читает по заданию: текст файла может содержать скрытую команду, рассчитанную на то, что агент примет её за указание пользователя. Подмена источника — агент может принять за достоверный документ подложный файл, если система не проверяет происхождение источника. Чрезмерные права — агенту выдан доступ шире, чем требует задача, и ошибка в одном сценарии открывает возможность для действий в другом. Несанкционированное действие — вызов инструмента без явного разрешения на конкретную операцию. Отсутствие аудита — без журнала невозможно установить, что именно произошло при сбое.
Практические меры защиты складываются в понятный список. Минимизация данных — агенту передаётся только то, что нужно для конкретной задачи, а не вся база целиком. Обезличивание — там, где возможно, персональные данные заменяются условными идентификаторами перед обработкой. Белый список инструментов — агент не может вызвать произвольный API, только те, что явно разрешены. Ручное подтверждение для операций с высокой ценой ошибки. Тестовые аккаунты для обкатки сценария перед переносом на реальные данные. Лимиты расходов, которые не дадут цепочке вызовов превысить разумный бюджет за один запуск. Журналирование каждого действия агента. И регулярная проверка настроек доступа — права, выданные полгода назад под одну задачу, могут оказаться избыточными для текущего состояния процесса.
Официальные разъяснения Роскомнадзора о персональных данных объясняют понятие оператора персональных данных и обязанности, которые возникают до начала обработки — это первая точка, с которой стоит сверяться при работе с данными клиентов через любую автоматизированную систему. Более широкий взгляд на то, как государство видит развитие технологий искусственного интеллекта в стране, дают стратегические документы России в области ИИ. Для тех, кто хочет протестировать агентные сценарии без лишних рисков на старте, подойдёт обзор Русскоязычные ИИ-сервисы: как пользоваться бесплатно — с него удобно начинать тестовый контур на минимальном бюджете.
Стоимость: как оценивать тарифы на автономные системы
Цена агентного сценария редко сводится к одной подписке на модель, и раскладывать её на составляющие полезнее, чем искать единое число «сколько это стоит».
Тарифы на автономные системы складываются из четырёх источников расходов. Первый — обработка запросов моделью: каждый вызов языковой модели стоит денег, и чем больше шагов в цепочке, тем больше таких вызовов. Второй — вызовы внешних инструментов: обращение к поиску, к стороннему API, к сервису генерации изображений часто тарифицируется отдельно от самой модели. Третий — хранение и поиск по данным: если агент работает с базой знаний компании, за объём хранения и за скорость поиска по нему тоже платят. Четвёртый — интеграции, контроль и ручная проверка: время специалистов, которые настраивают систему, проверяют результаты и реагируют на сбои, тоже часть реальной стоимости, даже если она не отражена в счёте от провайдера модели.
Сложная цепочка дороже короткого ответа по понятной причине: больше шагов означает больше вызовов модели, больше накопленного контекста, который передаётся на каждый следующий шаг, больше повторных попыток при сбоях и больше обращений к внешним сервисам. Простой вопрос-ответ без инструментов стоит в разы дешевле, чем десятишаговый сценарий с поиском, сопоставлением источников и генерацией изображения на выходе.
Три модели оплаты встречаются чаще всего. Фиксированная подписка — предсказуемый ежемесячный платёж с лимитом на объём использования, удобна при стабильной нагрузке. Оплата по факту использования — платёж пропорционален количеству запросов и вызовов, удобна при нерегулярной нагрузке и на этапе пилота, когда объём задач ещё не ясен. Смешанная модель — базовый пакет плюс доплата за превышение, компромисс между предсказуемостью и гибкостью. Важно держать в голове, что цена не равна качеству: дешёвый результат может потребовать больше редакторских исправлений, и экономия на обработке одного запроса иногда оборачивается ростом затрат на последующую правку.
Формула оценки пилота укладывается в одну строку: число задач за месяц умножить на среднюю стоимость одного запуска, и к этой сумме добавить резерв на ошибки и ручной контроль. Например, если бизнес планирует обрабатывать агентом сорок обращений в месяц, и каждый запуск сценария с поиском и проверкой стоит условную сумму, итоговый бюджет пилота — это произведение этих величин плюс запас процентов на ситуации, когда агент не справился и потребовалась ручная доработка. Этот расчёт полезнее абстрактного «агенты дорогие» или «агенты дешёвые» — он превращает оценку в конкретную цифру под конкретный объём задач.
AI агенты становится проще оценивать по стоимости, когда есть возможность сравнить несколько моделей на одной и той же задаче без необходимости заводить отдельный аккаунт и отдельный платёжный метод у каждого провайдера. Агрегатор вроде ModelStation решает именно эту практическую проблему: пользователь работает с разными моделями в одном интерфейсе и оплачивает использование по факту, а не держит открытыми несколько подписок ради одного эксперимента. Общий каталог доступных моделей и направлений работы собран на странице Все ТОП нейросети в одном пространстве — ModelStation.
Документация про официальное описание агентной инфраструктуры и её компонентов показывает, что в промышленных агентных платформах расходы на runtime, память, инструменты и тестирование учитываются отдельно друг от друга — именно эта декомпозиция и позволяет управлять итоговым бюджетом, а не гадать по общему счёту в конце месяца.
Как выбрать и запустить первого AI-агента
Маршрут запуска не требует от читателя навыков программирования — большинство решений принимаются на уровне постановки задачи и настройки ограничений, а не кода.
Шаг первый — выбрать одну повторяемую задачу с понятным результатом: не «автоматизировать поддержку», а «подготовить черновик ответа на типовой вопрос о статусе заказа». Шаг второй — описать входные данные, ограничения и критерий готовности: что агент получает на входе, чего он не должен делать, как понять, что результат годный. Шаг третий — определить, что агент может читать, а что только предлагать: доступ к базе заказов для чтения — да, изменение статуса заказа без подтверждения — нет. Шаг четвёртый — выбрать модель и инструменты под конкретную задачу, не самые мощные, а подходящие по соотношению качества и стоимости. Шаг пятый — прогнать тестовые примеры, включая намеренно сложные и некорректные входные данные. Шаг шестой — включить журналирование и лимиты: сколько шагов агент может сделать за один запуск, сколько стоит один запуск, где граница остановки. Шаг седьмой — сравнить результат агента с тем, что получилось бы при ручной обработке той же задачи. Шаг восьмой — постепенно расширить контур: добавить ещё один тип обращений, ещё один источник данных, ещё одно действие с подтверждением.
Сценарий ModelStation хорошо ложится на этот маршрут. Пользователь может сравнить несколько текстовых моделей на одном и том же промпте, чтобы увидеть разницу в стиле и точности до того, как выбрать модель для продуктивного сценария. Сохранение контекста позволяет не формулировать заново условия задачи при каждом обращении. Подготовка визуального материала — обложки, иллюстрации, короткого видео — доступна в том же интерфейсе, без переключения между разными сервисами. А оплата по факту использования даёт возможность оценить реальный расход на тестовых запусках прежде, чем принимать решение о масштабировании на весь отдел.
Первый пилот должен иметь четыре обязательных элемента: владельца, который отвечает за процесс; срок, на который рассчитан тест — например, три-четыре недели; набор тестовых задач, на которых сверяется качество; и условие остановки — конкретный порог ошибок или расходов, при достижении которого пилот приостанавливается для разбора, а не продолжается по инерции.
Тарифы на автономные системы на этапе первого пилота лучше оценивать по минимальному сценарию, а не сразу закладывать расходы на полную автоматизацию отдела — так проще увидеть реальную экономику до того, как бюджет вырастет вместе с масштабом. Возражение «нужно сразу создавать сложную многоагентную платформу» снимается прямой рекомендацией: начинать стоит с одного агента и минимального числа инструментов, а не с архитектуры из пяти специализированных ролей, согласования между которыми ещё никто не проверил на практике.
Официальная документация про различия между моделью и управляемым runtime агента объясняет, какие части агентного жизненного цикла может взять на себя сервис — инструменты, разрешения, сессии, выполнение, — а что остаётся на стороне разработчика сценария. Обзор бесплатных вариантов для первого теста собран в материале Бесплатные нейросети 2026: обзор сервисов | ModelStation, а сравнение текстовых генераторов — в материале Нейросети для текста: рейтинг 10 генераторов онлайн.
Главные ограничения и будущее автономных систем
Честный разбор границ технологии важнее красивых обещаний. Агент не обладает человеческим пониманием происходящего, не гарантирует истинность найденных сведений и не несёт ответственность вместо владельца процесса — ответственность всегда остаётся на человеке, который настроил сценарий и утвердил его работу.
Ограничения стоит перечислить конкретно, а не одним словом «несовершенство». Галлюцинации — модель может сгенерировать правдоподобно звучащий, но неверный факт, если ей не хватает достоверного источника. Зависимость от качества источников — агент, который ищет подтверждённые сведения, настолько хорош, насколько хороши документы и страницы, к которым у него есть доступ. Нестабильность длинных цепочек — чем больше шагов в сценарии, тем выше вероятность, что ошибка на одном из них исказит весь дальнейший результат. Уязвимость внешних документов — файл, который агент обрабатывает по заданию, может содержать скрытую инструкцию, рассчитанную на автоматическую систему. Рост расходов — сложные многошаговые сценарии стоят заметно дороже простых ответов. Сложность оценки — одна удачная демонстрация не доказывает, что агент одинаково хорошо справится с десятками разных входных данных. Необходимость регулярного обновления инструкций — правила, актуальные полгода назад, со временем расходятся с реальными процессами компании и нуждаются в пересмотре.
AI агенты развиваются в нескольких направлениях, и здесь уместнее говорить о векторах, а не о гарантированных прорывах. Специализированные агенты для узких задач вместо одной универсальной системы на всё. Взаимодействие нескольких ролей между собой по более строгим протоколам — так, чтобы передача задачи от одного агента другому происходила предсказуемо. Более жёсткие протоколы работы с инструментами — явные схемы входных и выходных данных, ограничения по умолчанию. Наблюдаемость — более подробные журналы и инструменты диагностики, которые позволяют быстро находить, на каком шаге цепочка пошла не так. Локальная обработка чувствительных данных — там, где это критично, часть вычислений выполняется ближе к месту хранения данных, а не пересылается во внешнее облако. Стандартизированные способы обмена между агентами разных разработчиков — чтобы системы от разных поставщиков могли взаимодействовать без индивидуальной интеграции под каждую пару.
Для российского рынка в этом развитии важны несколько практических моментов: доступность моделей для пользователей из Москвы, Санкт-Петербурга и других регионов без лишних барьеров, качество работы с русским языком — от грамматики до понимания местных реалий, интеграции с локальными сервисами и платёжными системами, требования к обработке данных в рамках действующего законодательства и прозрачность затрат при выборе между разными поставщиками моделей и инструментов.
Возражение «агенты полностью заменят специалистов» не подтверждается тем, как устроены автономные системы сегодня. Роль человека смещается, а не исчезает: от выполнения рутинных операций — к постановке задачи, проверке результата, принятию ответственности за финальное решение и разбору нестандартных случаев, с которыми агент не справился самостоятельно. Чем лучше настроен агентный сценарий, тем больше времени специалист тратит на содержательные решения и тем меньше — на механическую обработку однотипных запросов.
Правительственный документ про официальные цели цифровой зрелости и применения ИИ связывает развитие управления на основе данных именно с применением технологий искусственного интеллекта и обозначает горизонт планирования до 2030 года — это подтверждает, что направление развития автономных систем в стране задано на уровне долгосрочной стратегии, а не отдельных экспериментов компаний.
Агент, чат-бот, ассистент и автоматизация — в чём разница
Чат-бот отвечает на конкретный вопрос в рамках заранее заданного сценария, обычно без памяти между обращениями и без вызова внешних инструментов — пример: бот техподдержки, который по ключевым словам выдаёт готовый ответ из базы. Ассистент помогает в рамках диалога, удерживает контекст текущей сессии и может уточнять детали, но инициативу обычно удерживает пользователь — пример: помощник, который формулирует текст письма по инструкциям, но не отправляет его сам. Автоматизация выполняет заранее заданный маршрут без отклонений: если условие А, то действие Б — пример: правило, которое автоматически перемещает письмо с определённой темой в отдельную папку. Агент отличается тем, что выбирает следующий шаг самостоятельно в пределах заданных правил, опираясь на текущий контекст, а не на жёстко прописанный маршрут — пример: система, которая решает, нужен ли для ответа клиенту поиск по базе знаний или сразу можно отвечать по шаблону. Ни одно из четырёх решений не универсально лучше остальных: простая автоматизация надёжнее там, где условия стабильны и не меняются, а агент полезнее там, где входные данные неполные и каждый раз требуют выбора.
Языковая модель как ядро агентного поведения
Модель интерпретирует инструкции, оценивает контекст и выбирает наиболее вероятный следующий шаг — ответить текстом или сформировать аргументы для вызова инструмента. Она не становится самостоятельным источником истины: её ответ настолько хорош, насколько хороши инструкции, контекст и данные, с которыми она работает. Результат зависит от системных инструкций, примеров правильного поведения, заданного формата ответа и качества подключённых источников — слабый источник данных испортит даже идеально настроенный промпт. Разные модели по-разному справляются с длинным контекстом, планированием многошаговых задач, русским языком, написанием кода и работой с изображениями и видео одновременно, поэтому выбор модели под конкретный агентный сценарий — отдельная задача, а не формальность.
Память, знания и контекстное окно
Контекстное окно — это объём текста, который модель может обработать за один вызов: чем он больше, тем больше документов и предыдущих сообщений помещается в один запрос. Сохранённая память — это отдельные заметки о проекте или пользователе, которые переживают конец сессии. Внешняя база знаний — это документы и данные, по которым агент ищет нужную информацию, не загружая всё содержимое целиком в контекст. Агент не обязан помнить весь диалог целиком: важные факты фиксируются отдельно, а остальное можно отбросить без потери качества. Поиск по документам не равносилен обучению модели — модель не запоминает содержимое файла навсегда, она лишь читает его в момент запроса. Пример: инструкция по оформлению договоров, обновлённая месяц назад, но не переиндексированная в базе знаний агента, приведёт к тому, что агент продолжит ссылаться на старую версию правил, пока источник, дата обновления и версия документа не будут явно обновлены в системе.
Инструменты и протоколы взаимодействия
Функции, API, поиск, базы данных, файловые операции и внешние сервисы расширяют возможности модели за пределы генерации текста. Чтобы инструмент работал предсказуемо, у него должно быть понятное описание назначения, чёткая схема входных данных — какие параметры принимает вызов, ожидаемый формат результата, описанные ограничения — что инструмент не умеет или не должен делать, и предусмотренная обработка ошибок на случай сбоя или недоступности сервиса. Подключение инструмента само по себе не означает автоматическое право на любое действие с его помощью: доступ к API платёжной системы для чтения баланса — это одно разрешение, а право инициировать перевод — совсем другое, и их нельзя смешивать при настройке прав агента.
Планирование, ReAct и проверка промежуточных результатов
Бытовой пример: человек ищет квартиру и после каждого просмотра корректирует критерии поиска — увидел один вариант, понял, что этаж важнее метража, и дальше ищет уже с новым приоритетом. Агенту иногда нужен похожий цикл: сделать шаг, посмотреть на результат, скорректировать следующий шаг, снова проверить. Это не повод углубляться в академические схемы вроде цепочек рассуждений — достаточно понимать практический эффект: промежуточные проверки помогают находить ошибку раньше, до того как она повлияет на финальный результат, но каждая дополнительная проверка увеличивает время выполнения и стоимость запуска. Поэтому у такого цикла должны быть точки остановки — условия, при которых агент прекращает попытки и передаёт задачу человеку, — и лимит количества итераций, чтобы цепочка не могла повторяться бесконечно при неудачном сценарии.
Типы агентов по уровню автономности
Реактивные агенты отвечают на конкретный стимул без построения плана — подходят для простых повторяющихся действий, риск в том, что они плохо справляются с нестандартной ситуацией. Планирующие агенты выстраивают последовательность шагов заранее — подходят для многоэтапных задач, риск в том, что план может оказаться неактуальным при изменении условий на полпути. Инструментальные агенты сфокусированы на вызове внешних сервисов для получения или изменения данных — подходят для интеграционных сценариев, риск в избыточных правах доступа. Многоагентные системы распределяют задачу между несколькими специализированными ролями — подходят для сложных процессов с чёткими зонами ответственности, риск в росте стоимости и сложности отладки. Полностью управляемые человеком решения оставляют финальное действие за специалистом, а агент только готовит материал — подходят для задач с высокой ценой ошибки, риск здесь минимален технически, но теряется часть скорости. Термин «автономный» описывает степень самостоятельности агента внутри заданной среды и набора правил, а не отсутствие контроля, правил и ответственности за результат.
Где агенту нужен человек в контуре
Есть три рабочих режима контроля. Предварительное подтверждение — агент готовит действие, но не выполняет его без явного согласия человека. Выборочная проверка результата — агент действует самостоятельно, но часть выполненных операций случайным образом или по правилу попадает на ручную сверку. Обязательная передача человеку при исключении — если входные данные не укладываются в типовой сценарий или результат получился противоречивым, агент прекращает попытки и направляет задачу специалисту. Операции, которые нельзя оставлять без контроля: платежи любого объёма, публикация юридически значимого текста — договора, официального ответа, пресс-релиза, изменение данных клиента в основной системе и удаление файлов без возможности восстановления. Человеческое участие нужно встраивать в процесс на этапе проектирования сценария, а не добавлять постфактум после первого серьёзного инцидента — тогда оно появляется слишком поздно, когда ошибка уже случилась.
Как тестировать качество агентного сценария
План тестирования строится на трёх группах примеров. Типовые задачи — то, с чем агент будет сталкиваться каждый день, и на них проверяется базовое качество. Сложные случаи — пограничные ситуации, где входные данные неполные или противоречивые. Намеренно ошибочные входные данные — проверка того, что агент не выдаёт уверенный, но неверный ответ там, где должен остановиться и попросить уточнение. Для каждого примера заранее фиксируется ожидаемый результат, чтобы сравнение было объективным, а не основанным на общем впечатлении. Дальше проверяется корректность вызовов инструментов — обращается ли агент к нужному источнику и с правильными параметрами, устойчивость к сбоям — что происходит, если внешний сервис временно недоступен, соблюдение прав доступа — не пытается ли агент выполнить действие, на которое у него нет разрешения, и стоимость запуска — укладывается ли сценарий в ожидаемый бюджет. Одна удачная демонстрация на выбранном примере не доказывает надёжность системы: нужен набор из десятков разных кейсов, включая заведомо сложные, прежде чем переводить агента в продуктивную работу.
Многоагентные системы и распределение ролей
Разделение процесса между специализированными ролями оправдано, когда задача естественно распадается на независимые этапы с разной спецификой: исследователь собирает и проверяет факты, редактор отвечает за стиль и структуру текста, проверяющий сверяет итог с источниками и требованиями, координатор следит за тем, чтобы результат одного этапа корректно передавался на следующий. Преимущества такого подхода — декомпозиция сложной задачи на понятные части, отдельные инструкции под каждую роль без конфликта требований, и чёткие зоны ответственности при разборе ошибки. Недостатки не менее реальны: больше вызовов модели на одну и ту же итоговую задачу, сложнее организовать общую память между ролями без потери или искажения контекста, выше суммарная стоимость запуска и больше точек, где цепочка может застрять. Начинать стоит с одной роли, если задача не требует явной параллельной работы над разными частями результата — большинство сценариев для контент-команды или малого бизнеса решаются одним хорошо настроенным агентом без разделения на несколько ролей.
Локальные, облачные и агрегированные решения
Три подхода к размещению агента отличаются по нескольким параметрам. Локальная модель, развёрнутая на собственных серверах компании, даёт максимальный контроль над данными — ничего не покидает инфраструктуру организации, но требует собственных вычислительных мощностей, более медленного обновления до новых версий моделей и отдельной команды для поддержки. Облачное решение от крупного провайдера даёт доступ к постоянно обновляемым моделям и готовым инструментам без необходимости держать собственное железо, но данные обрабатываются на стороне провайдера, и масштаб инфраструктуры там, как правило, больше, чем может позволить себе небольшая компания самостоятельно. Агрегированное решение вроде ModelStation позволяет сравнивать несколько моделей разных провайдеров в одном интерфейсе и платить по факту использования, не разворачивая собственную инфраструктуру и не завязываясь на одного поставщика — это удобно именно на этапе выбора и тестирования, когда ещё не ясно, какая модель лучше справится с конкретной задачей и какой объём работы предстоит. Категоричного правильного ответа здесь нет: локальная модель нужна там, где требования к данным строгие и не допускают передачи во внешнее облако, облачное решение — там, где важны масштаб и готовая инфраструктура, а агрегатор — там, где на первом месте стоит сравнение качества разных моделей и контроль расходов без долгосрочных обязательств перед одним провайдером.
Итог
AI-агенты — это не отдельная модель и не переименованный чат-бот, а контур из модели, памяти, инструментов, правил и оркестрации, который доводит задачу от цели до проверенного результата. Разобравшись в компонентах этой системы, читатель перестаёт воспринимать агента как чёрный ящик и начинает видеть конкретные рычаги управления качеством и риском.
- Агент отличается от чат-бота и автоматизации способностью выбирать следующий шаг в пределах заданных правил, а не просто отвечать одним сообщением или идти по жёстко прописанному маршруту.
- Архитектура агентной системы складывается из модели, инструкций, памяти, инструментов и оркестратора, и слабое звено в любом из этих элементов портит результат даже при сильной модели.
- Полный цикл выполнения задачи проходит через постановку цели, план, вызов инструмента, проверку промежуточного результата и, при необходимости, остановку с передачей решения человеку.
- Выбор сценария — от контент-команды до поддержки клиентов и аналитики — стоит делать по критерию окупаемости: задача должна повторяться, занимать заметное время и допускать проверку результата.
- Безопасность, приватность, требования 152-ФЗ и прозрачная структура расходов — это не дополнение к внедрению, а часть проекта с самого первого дня, а не исправление постфактум.
- Первый практический шаг — запустить один узкий пилот с владельцем, сроком, тестовыми задачами и условием остановки, постепенно расширяя полномочия агента только после проверки результата на практике.