С чего начать: какую задачу решает ИИ-видео
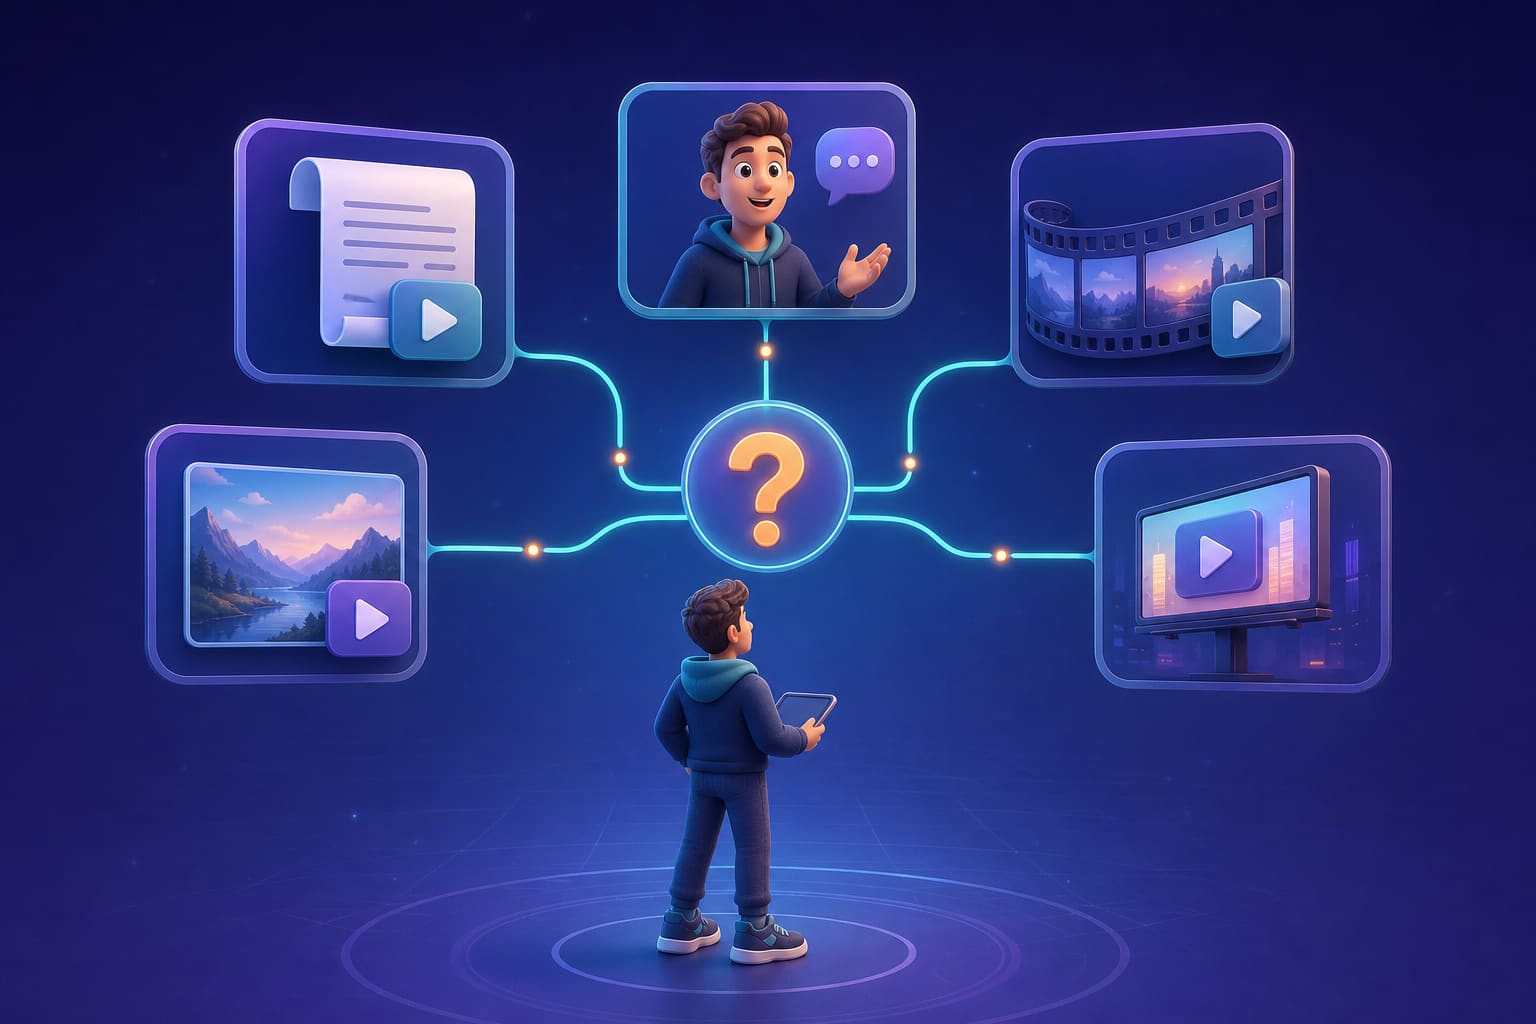
Пользователь открывает вкладку за вкладкой: один сервис просит оплатить подписку заранее, другой требует подтверждение по почте, третий не поддерживает нужный формат ролика. Вопрос «где сделать ии видео» возникает не от любопытства, а от усталости перебирать варианты вслепую и получать то смазанное лицо, то неподходящий формат кадра.
Нейросети для видео отличаются не только красотой картинки. У них разный тип входных данных — текстовое описание или фотография, разная длительность сцены (от трёх секунд до минуты), разный уровень контроля камеры, разное поведение персонажа между кадрами, разное наличие звука и, что немаловажно для российского пользователя, разный способ оплаты.
Пять сценариев требуют разных инструментов. Текст-видео подходит, когда сцену нужно придумать с нуля, без исходного изображения. Изображение-видео держится ближе к реальному объекту: фотография товара или лицо человека сохраняются точнее. Продолжение готового фрагмента решает задачу развития короткого сюжета. Аватар с речью закрывает обучающие видео и презентации. Монтаж текстовыми командами ускоряет сборку готового материала из нескольких кусков.
Ролик для Reels нельзя выбирать по тем же критериям, что рекламный фильм или раскадровку для питча. Вертикальный формат живёт первые полторы секунды — там решает скорость и крупный план в центре кадра. Рекламный ролик требует стабильной формы продукта кадр за кадром. Раскадровка ценит атмосферу и движение камеры больше, чем мелкие детали.
Фраза «достаточно взять самую популярную модель» на практике не работает. Как сделать ИИ видео, которое реально подойдёт под задачу, определяет не рейтинг узнаваемости, а совпадение сервиса с форматом, языком интерфейса и доступом из России. Дальше разобраны конкретные сценарии, а не абстрактный топ без контекста.
Как работают нейросети для видео: текст, изображение и референсы
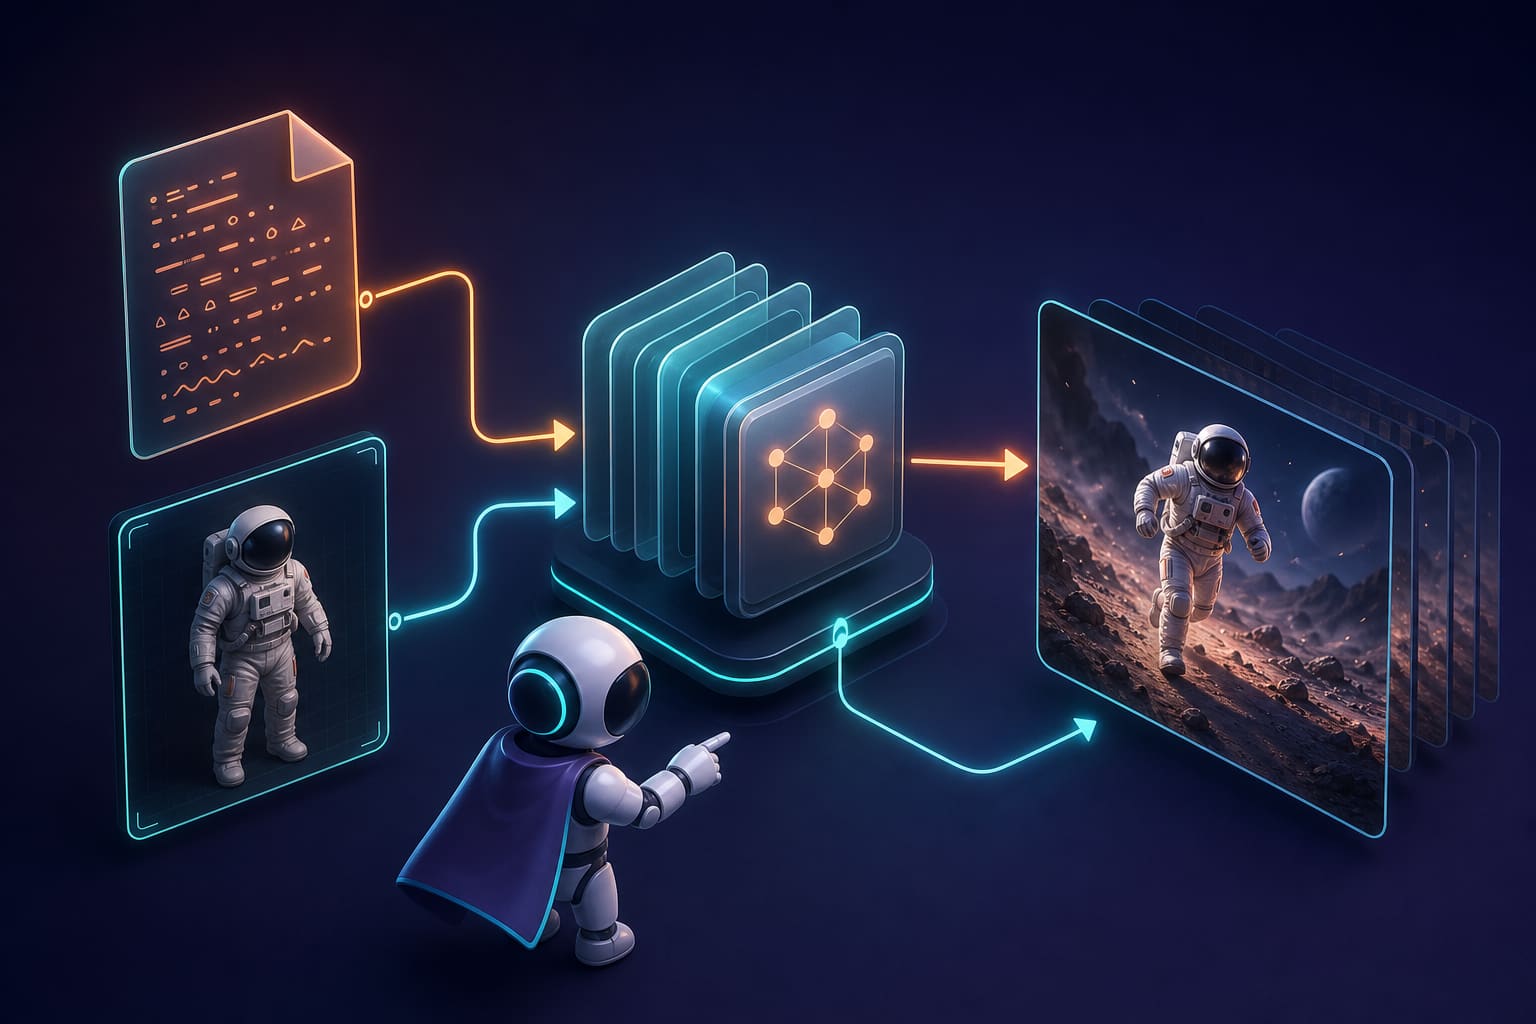
Пользователь задаёт описание сцены текстом, загружает изображение или собирает несколько референсов — после этого модель строит короткую последовательность кадров. Разница между режимами принципиальна: в text-to-video композицию придумывает сама нейросеть которая создает видео по описанию, а в image-to-video исходная фотография удерживает внешний вид объекта точнее, хотя движение иногда выглядит механическим.
Описывать стоит не только предмет. Камера, движение, свет, фон и темп сцены формируют результат не меньше, чем сам объект. Промпт «девушка идёт по улице» даёт случайный результат, а «девушка идёт по вечерней улице, камера медленно двигается следом, мягкий свет фонарей» — управляемый.
Один запрос редко создаёт готовый фильм. Чаще получается короткий фрагмент на три-восемь секунд, который нужно продлить, смонтировать или повторить с уточнённым промптом. Именно поэтому вопрос «ии где можно сделать видео» стоит переформулировать: важнее понять, как собрать несколько коротких генераций в связный ролик, а не найти один универсальный сервис.
Современные официальные инструменты поддерживают генерацию из текста и изображения одновременно, но возможности, сроки хранения результата и доступное разрешение зависят от конкретной модели. Подробности по рекомендуемым промптам и ограничениям публикует OpenAI в официальных материалах по генерации видео. Нейросети для видео не понимают длинный сценарий одним запросом — абзац с десятью действиями сервис либо упростит, либо проигнорирует часть деталей.
Рейтинг 2026: лучшие нейросети для создания роликов
Рейтинг строится не по абстрактному месту в списке, а по задачам. Для сравнения взяты одиннадцать критериев: реалистичность движения, устойчивость персонажа между кадрами, точность следования промпту, работа с исходным изображением, управление камерой, наличие звука, длительность сцены, доступное разрешение, скорость генерации, доступность из региона и цена.
В какой нейросети можно сделать видео под конкретную задачу — разбирают четыре ключевых участника рынка и агрегатор, где доступно сразу несколько моделей без отдельных регистраций. У каждого инструмента есть сильная сторона и слабое место, и ни один не выигрывает по всем параметрам сразу.
| Инструмент | Сильная сторона | Подходящий сценарий | Ограничение |
|---|---|---|---|
| Sora | Сложные сцены и движение камеры | Концептуальные и кинематографичные фрагменты | Доступ и лимиты зависят от продукта и региона |
| Veo 3.1 | Видео с нативным звуком и референсами | Сцены с диалогом, атмосферой и заданными кадрами | Генерация короткими фрагментами, часть функций в preview |
| Kling | Управление движением, multi-shot и image-to-video | Персонажи, экшен и последовательные сцены | Требуется точная настройка промпта и параметров |
| Runway Gen-4.5 | Текст-видео, изображение-видео и итеративная работа | Креативный продакшен и быстрые правки | Расход кредитов и ограничения тарифного плана |
Нейросеть видео создать на русском языке проще там, где локализован интерфейс, но внутренняя модель всё равно лучше распознаёт промпты на английском — об этом подробнее в разделе про доступ из России. Сравнение нейросетей видео полезно именно как инструмент выбора под задачу, а не как абсолютная оценка качества кадров во всех жанрах: подробное описание режимов Veo доступно в официальной документации Google Veo. Список обновлён под реалии 2026 года и опирается на проверяемые параметры моделей, а не на маркетинговые обещания.
Sora: когда важны сложная сцена и кинематографичность
Sora подходит тем, кому нужен выразительный короткий фрагмент с несколькими объектами, движением камеры и атмосферой — не идеальный финальный ролик, а убедительный черновик идеи. Модель хорошо справляется с концептом рекламного ролика, раскадровкой для питча, фантастической сценой, визуальной метафорой и тестом идеи до реальной съёмки.
Ограничения стоит учитывать заранее. Sora не заменяет полноценный монтаж: звук, титры и финальную цветокоррекцию добавляют отдельно. Персонажи и мелкие детали — цвет одежды, форма предмета, черты лица — могут незначительно меняться между генерациями, поэтому длинный сценарий лучше делить на отдельные сцены, а не пытаться уместить его в один запрос.
Где нейросеть создает видео стабильно хорошо — это одиночные выразительные кадры с одной идеей и одним главным действием. Где сделать видео с помощью ии для серийного производства — вопрос сложнее: демонстрационный ролик на сайте компании показывает лучший из десятков результатов, а не типичный. Оценивать модель стоит по стабильности нескольких генераций подряд с одним и тем же промптом, а не по единственному удачному кадру.
Как сделать ИИ видео с Sora без разочарования: формулировать короткую сцену с одним действием, фиксировать стиль камеры словами «медленный проезд» или «статичный план», и готовиться повторить генерацию два-три раза перед тем, как считать результат окончательным. Официальное описание модели и её назначения приводит OpenAI на странице Sora.
Veo: выбор для звука, референсов и заданных кадров
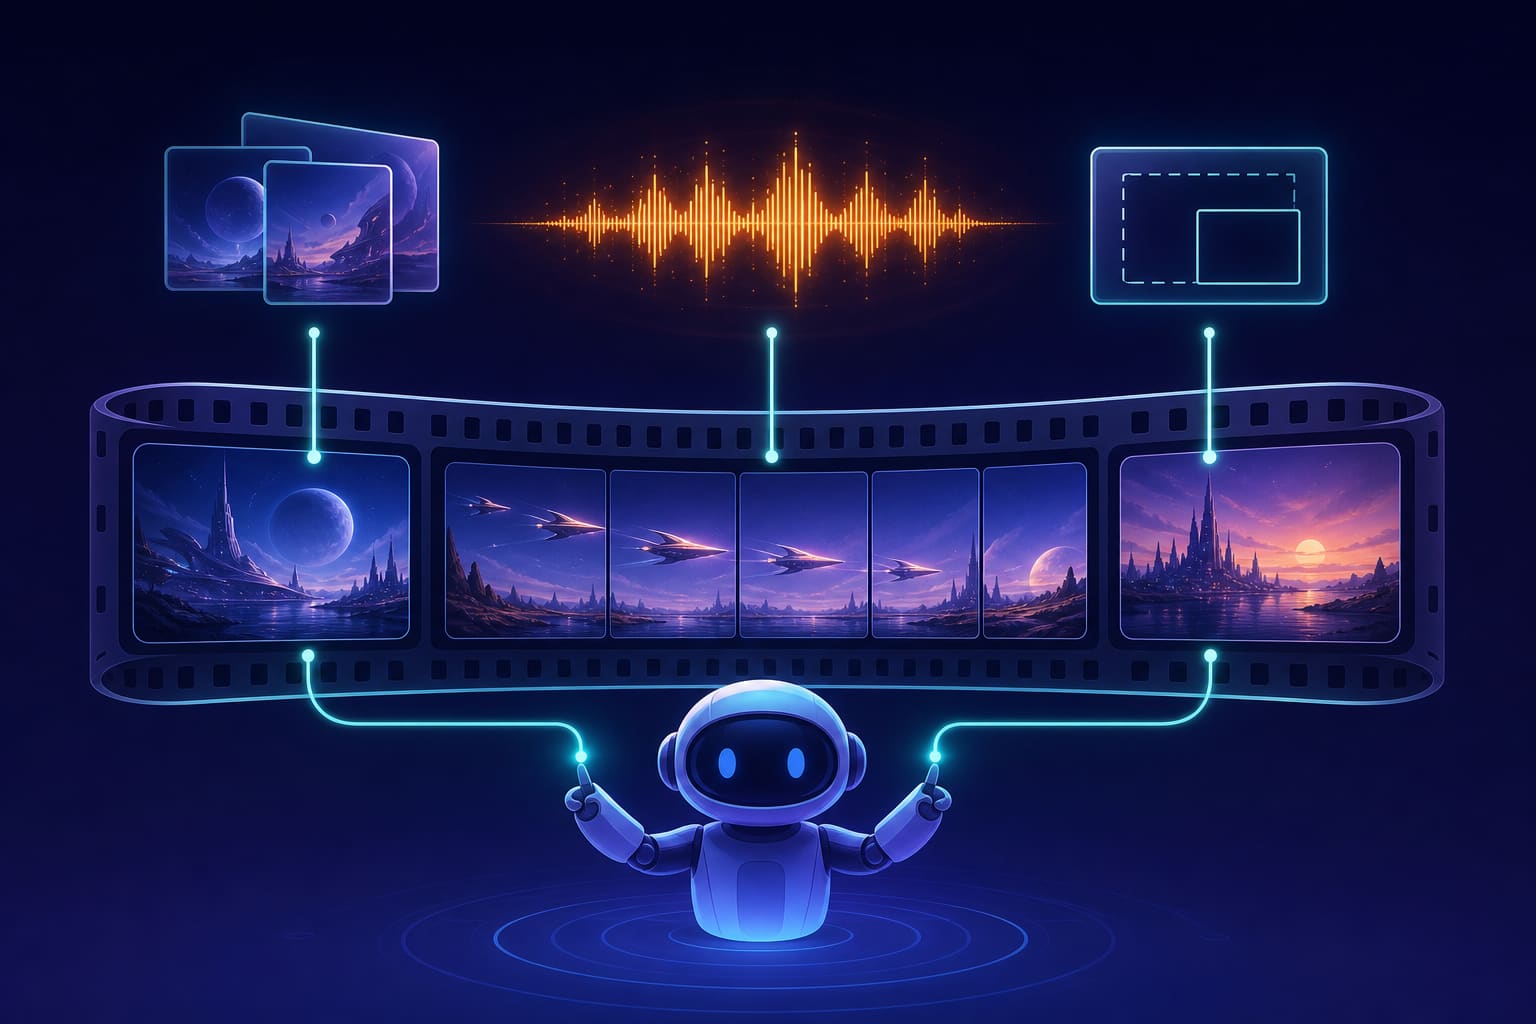
Veo выигрывает там, где важна не только картинка, но и звуковая среда: речь персонажа, шум улицы, музыка, атмосфера сцены. Это редкость среди видеомоделей — большинство конкурентов отдают звук на откуп отдельному аудиоредактору, а Veo 3.1 генерирует его нативно вместе с изображением.
Подтверждённые возможности версии 3.1: генерация роликов длительностью 8 секунд, варианты разрешения 720p, 1080p и 4K при соответствующих условиях тарифа, вертикальное и горизонтальное соотношение сторон, использование первого и последнего кадра для управления переходом, до трёх референсных изображений и нативно создаваемый звук без отдельной генерации.
Google указывает английский язык как полностью поддерживаемый, поэтому русскую речь и текст в кадре необходимо тестировать отдельно — результат может звучать иначе, чем ожидается, особенно в именах собственных и сложных конструкциях. Программа ии сделать видео с диалогом на русском языке потребует нескольких попыток и, вероятно, ручной коррекции субтитров после генерации.
Результат хранится на сервере ограниченное время, файл нужно скачать сразу после завершения генерации, иначе доступ к нему пропадёт. Нейросеть про создать видео с заданным началом и концом сцены полезна для рекламных роликов, где важно показать товар крупным планом в финальном кадре. Где сделать ии видео со звуковой дорожкой без дополнительного монтажа — именно здесь, но звук не гарантирует идеальную дикцию и точную синхронизацию губ при сложных фразах: это стоит проверять на тестовом фрагменте перед финальной сборкой. Подробности о творческих возможностях модели публикует Google DeepMind на странице Veo.
Kling: управляемое движение и последовательные сцены
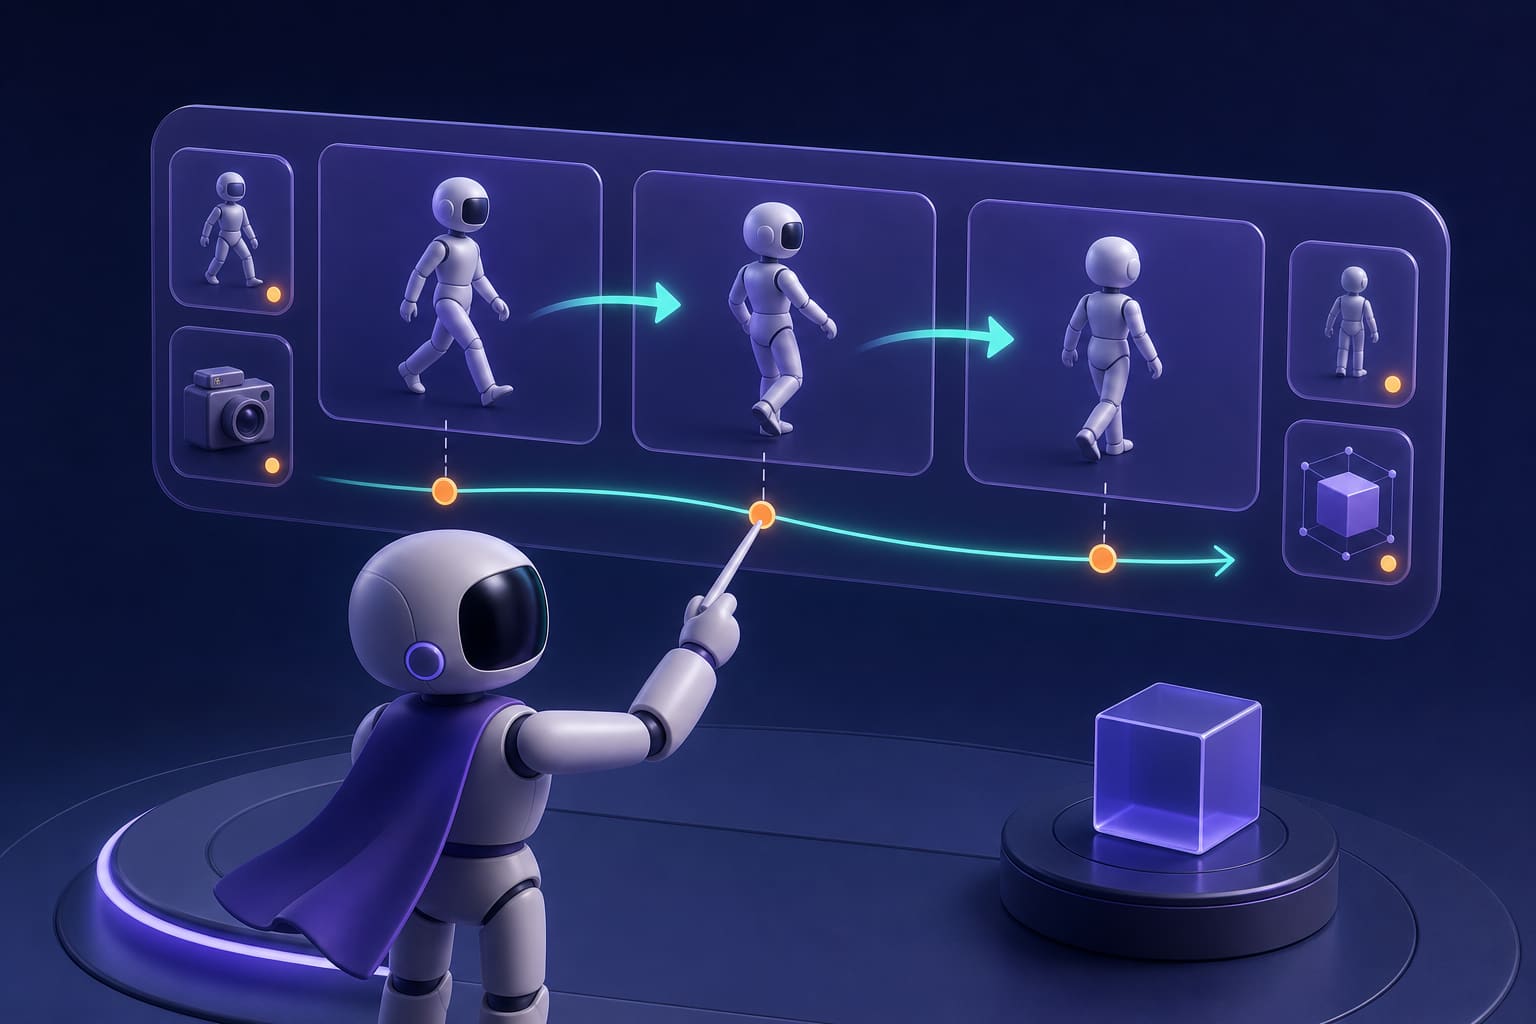
Kling подходит тем, кто хочет контролировать движение, персонажа, несколько планов и переходы между сценами, а не полагаться на случайный результат. Официально заявлены режимы text-to-video, image-to-video, multi-shot для нескольких планов подряд, native audio, управление движением через указание траектории, работа со стартовыми и финальными кадрами и использование референсных элементов для сохранения внешности.
Особенно полезен Kling для экшена, танца, движения камеры вдоль сцены, рекламной демонстрации товара с поворотом на 360 градусов и короткой истории из нескольких последовательных планов. В какой нейросети можно создать видео с управляемой траекторией персонажа — именно здесь, потому что multi-shot позволяет задать не одну сцену, а связку из двух-трёх.
Слабые места тоже заметны. Сложный промпт с несколькими одновременными действиями модель может интерпретировать непредсказуемо — она выберет одно действие и проигнорирует остальные. Мелкие детали вроде пальцев рук и мимики требуют нескольких повторных попыток, прежде чем результат станет приемлемым. Где сделать видео с нейросетью, которая держит персонажа стабильным дольше восьми секунд — длинный ролик всё равно лучше собирать из отдельных сцен, а не рассчитывать на одну длинную генерацию.
Много настроек не упрощает работу автоматически: каждый дополнительный параметр движения камеры, скорости и референса нужно задавать осознанно, иначе итоговый результат выйдет хаотичным. Сравнение нейросетей видео по управляемости движения ставит Kling в число лидеров именно за счёт этой детализации. Официальный quickstart с описанием режимов публикует Kling AI.
Runway: рабочий вариант для креативного продакшена
Runway устроен не как разовый генератор, а как рабочий процесс: текст-видео, изображение-видео, повторные варианты одного и того же промпта, организация сессий по проектам и работа с несколькими сценами в одном пространстве. Это нейросеть которая создает видео с прицелом на итерацию, а не на единственную попытку.
Актуальная информация из справки Runway: модель Gen-4.5 поддерживает text-to-video и image-to-video, а при работе с изображением промпт должен прежде всего описывать движение — содержание исходной картинки уже задано, и переописывать его заново только перегружает запрос и сбивает модель с толку.
Где сделать видео с нейросетью, где удобно быстро перебирать десять вариантов одной сцены подряд — здесь: интерфейс изначально рассчитан на дизайнеров, режиссёров, рекламные команды и авторов, которые сравнивают результаты и выбирают лучший, а не ждут единственного правильного ответа с первого раза.
Профессиональный интерфейс не всегда усложняет работу новичку: базовые режимы text-to-video и image-to-video доступны без глубокого погружения в настройки, а продвинутые инструменты подключаются по мере необходимости. Как сделать ИИ видео с минимальными потерями кредитов — заранее определить длительность сцены и не запускать генерацию «на пробу» без черновика промпта, потому что каждая попытка расходует баланс тарифа. Подробные рекомендации по промптам для Gen-4.5 приводит справка Runway по генерации видео.
Где сделать видео для соцсетей, рекламы и карточки товара
Рейтинг моделей — только половина решения. Для вертикальных роликов в Reels и сторис важны скорость генерации, формат 9:16, крупный объект в центре кадра и короткий, выразительный первый кадр: зритель решает, листать дальше или остаться, за полторы секунды.
Для рекламы главное — читаемость продукта, стабильная форма упаковки от кадра к кадру, понятное действие героя и свободное место в композиции под будущие титры. Может ли ии сделать видео, которое продаёт само по себе — да, но только как визуальная основа: финальные цифры, цены и юридические дисклеймеры добавляют в монтаже отдельно.
Для карточки товара модель лучше использовать для демонстрации движения, фактуры материала и контекста использования, но точные характеристики — размер, цвет, состав — нельзя оставлять на усмотрение генератора: сервис может слегка исказить форму или оттенок при повторной генерации. Через какой ии можно сделать видео с озвученным объяснением — для обучающего ролика полезен аватар с речью, субтитры и монтаж готовых сцен в один связный ряд.
Где сделать ии видео для регулярного контента, не теряя время на пять отдельных аккаунтов — выгоднее работать через единый интерфейс с несколькими моделями, особенно когда нужно сравнить результаты на одном и том же промпте и выбрать лучший без лишних переключений между вкладками. Нейросети для видео не заменяют монтажёра и редактора: они создают исходник, а сборка, звук и титры остаются ручной работой.
Русский язык, доступ из России и стоимость генерации
Для пользователя из Москвы, Санкт-Петербурга и других городов России есть три практических ограничения. Интерфейс сервиса может быть русским, но сама модель чаще лучше понимает промпт на английском — короткий тест одной фразы на двух языках быстро это покажет. Оплата может зависеть от типа карты, региона выставления счёта и наличия посредника для международных платежей. Бесплатный режим почти всегда ограничивает разрешение, скорость очереди, число попыток в сутки или экспорт без водяного знака.
Стоимость подписки и цена одной генерации — разные вещи. Месячный тариф может включать фиксированное число кредитов, а одна генерация ролика расходует часть этого лимита независимо от того, понравился результат или нет. Можно ли сделать видео с ии бесплатно — да, но с ограничениями по длительности и количеству попыток, и тестировать пять разных сервисов по отдельности ради одного удачного ролика часто выходит дороже, чем протестировать их через единый агрегатор.
В какой нейросети можно сделать видео без необходимости заводить пять аккаунтов и пять подписок — у агрегатора ModelStation единый баланс покрывает доступ к разным моделям, оплата списывается по факту использования, а история расходов видна в одном месте без необходимости сверять пять отдельных счетов. Это удобно именно на этапе выбора, когда ещё не ясно, какая модель подойдёт под конкретную задачу.
Бесплатная генерация не всегда означает отсутствие расходов: ограничение по количеству попыток в сутки означает, что после исчерпания лимита либо ждать сброса, либо переходить на платный тариф. Нейросети для видео из бесплатного сегмента редко дают разрешение выше 720p и часто добавляют заметный водяной знак в угол кадра.
Как написать промпт для первого удачного ролика
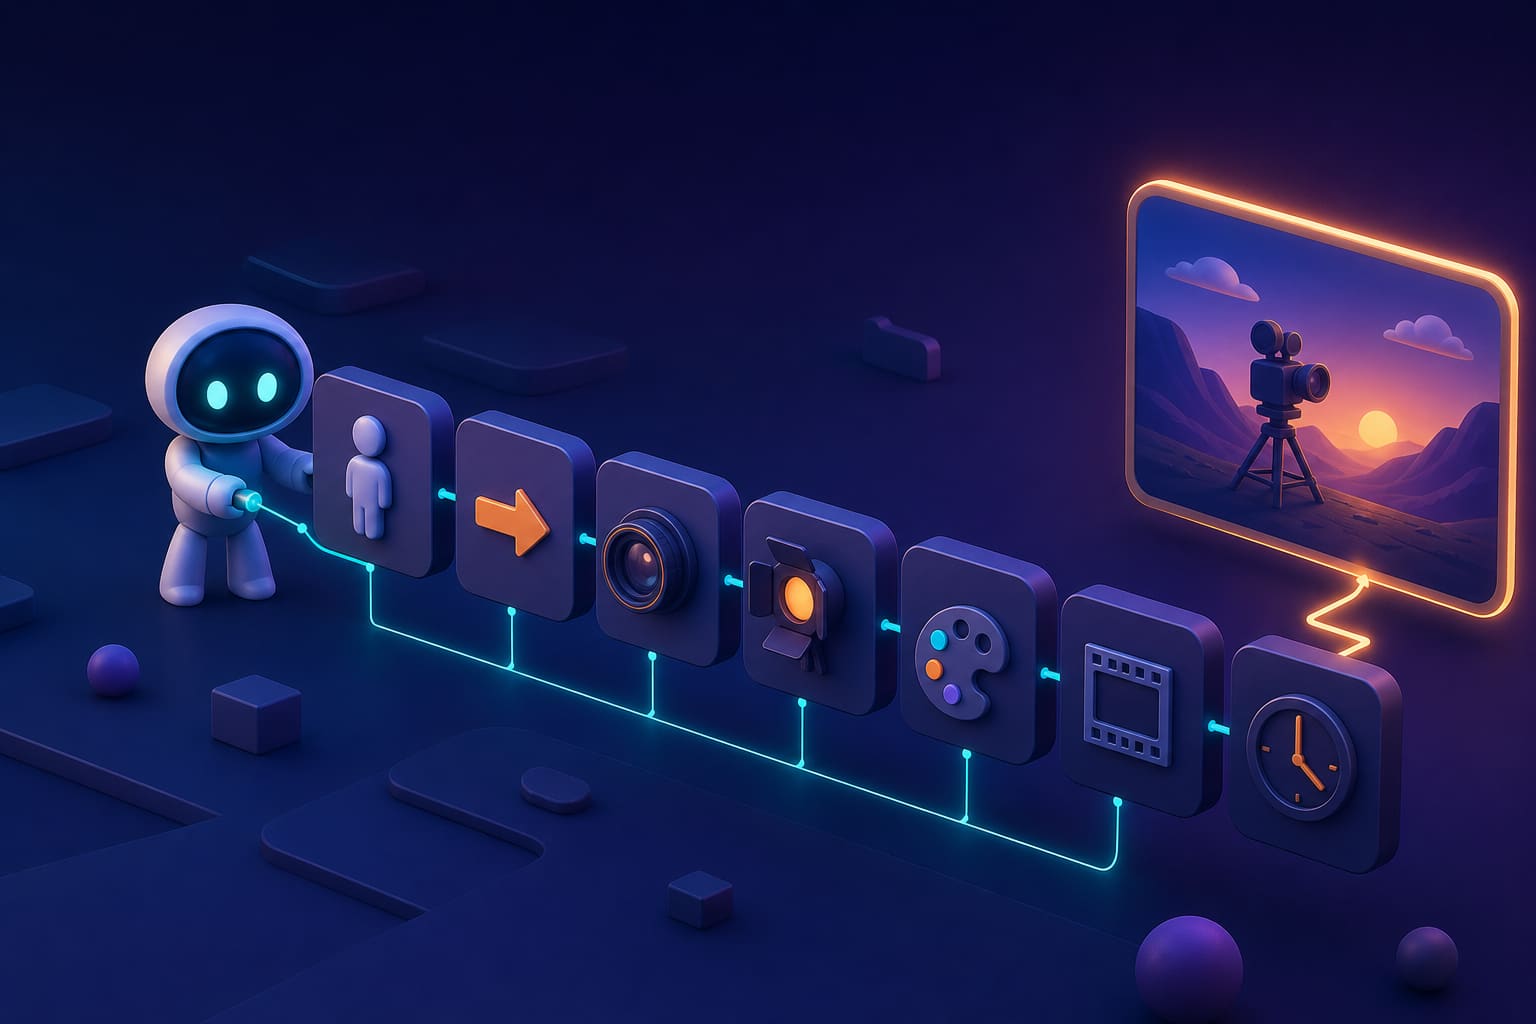
Рабочая формула промпта состоит из девяти элементов: объект или персонаж, действие, окружение, визуальный стиль, движение камеры, свет, композиция кадра, длительность и формат. Пропуск любого пункта модель заполнит на своё усмотрение, и результат может не совпасть с ожиданием.
Слабый запрос «красивый ролик про Москву» даёт случайную сборку из штампов: Красная площадь, огни, случайные прохожие. Конкретное описание работает иначе: «вечерняя улица, один герой в тёмном пальто, медленный проезд камеры слева направо, лёгкий дождь, естественный свет фонарей, вертикальный формат 9:16, без смены одежды и лица в течение всей сцены». Разница в результате заметна с первой попытки.
Для image-to-video не нужно заново описывать все детали исходной картинки — модель уже видит цвет, форму и композицию фотографии. Программа ии сделать видео из загруженного фото работает точнее, если промпт сосредоточен на движении и изменениях сцены: «персонаж медленно поворачивает голову, фон остаётся статичным, лёгкое движение волос».
Для нескольких планов лучше разделять запрос на короткие кадры, а не пытаться уместить весь сюжет в одну генерацию: нейросеть про создать видео с пятью последовательными действиями в одном запросе обычно выбирает одно-два и игнорирует остальные. Как сделать ИИ видео без лишних артефактов — добавлять в промпт прямые ограничения: «без лишних объектов», «без изменения лица», «без текста в кадре», «без резких скачков камеры». Длинный и перегруженный промпт на пятнадцать прилагательных не даёт лучшего результата — он просто размывает фокус модели между слишком многими требованиями одновременно.
Пошаговый процесс: от идеи до готового файла
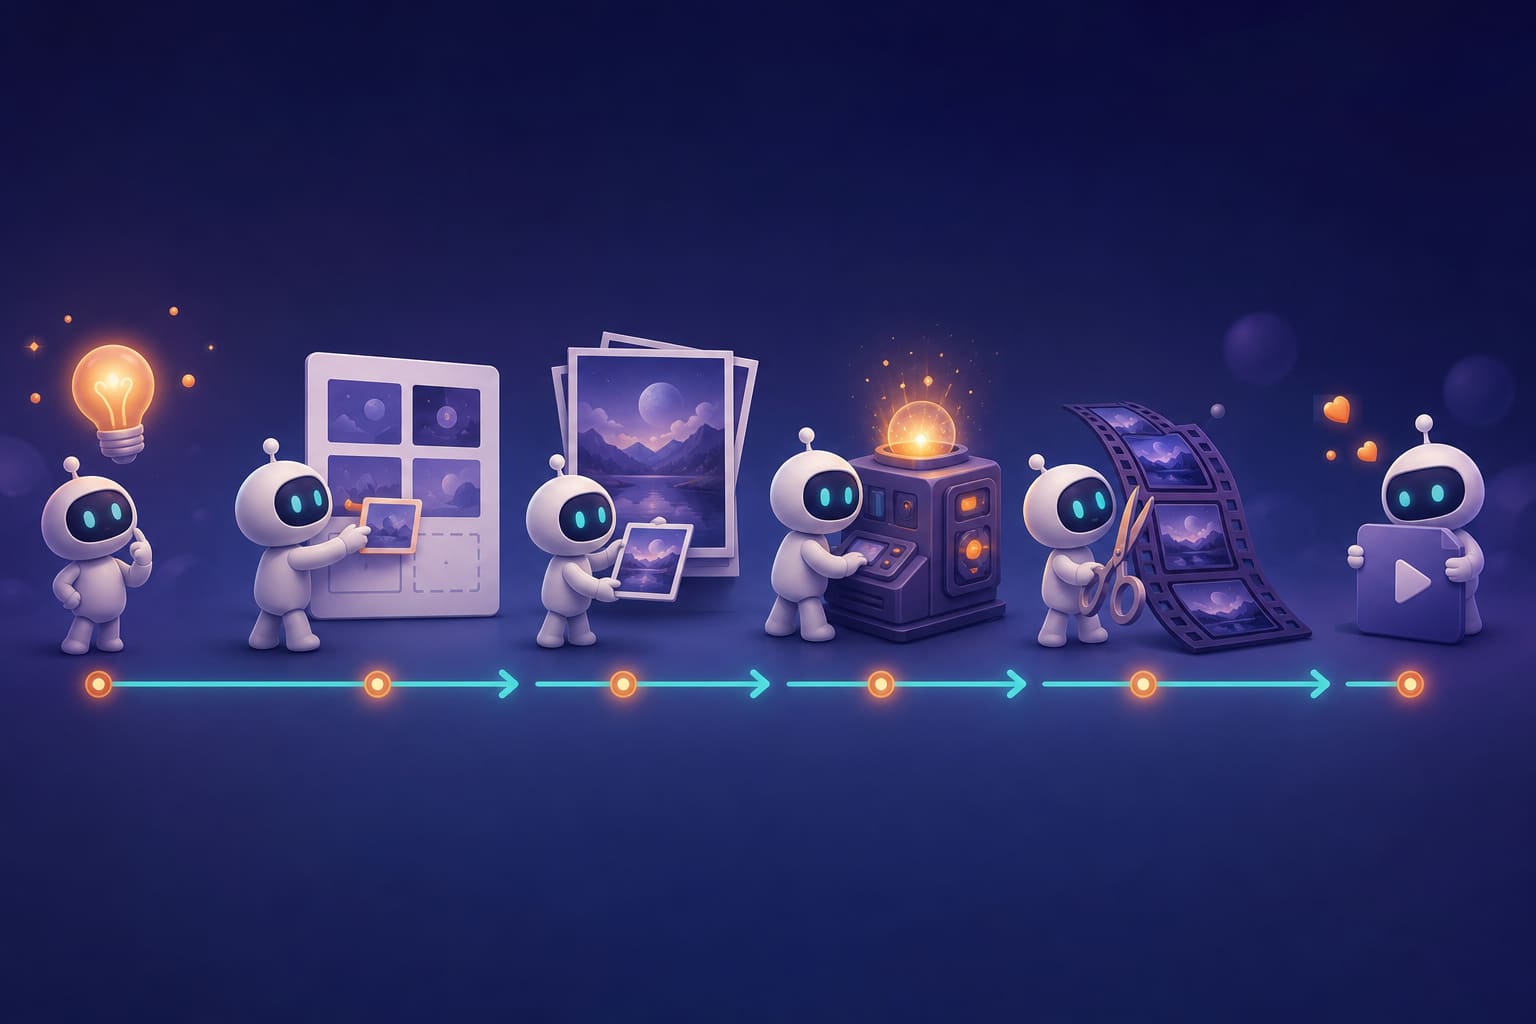
Процесс состоит из шести этапов, и у каждого есть понятный критерий перехода дальше. Первый — сформулировать цель ролика: реклама, обучение, соцсети или концепт. Второй — выбрать формат и длительность, исходя из площадки размещения. Третий — подготовить референс или короткую раскадровку из двух-трёх кадров.
Четвёртый этап — написать промпт по формуле из предыдущего раздела. Пятый — создать несколько коротких вариантов одной и той же сцены, а не одну генерацию: в какой нейросети можно создать видео с первой попытки — редкость, обычно нужно от трёх до пяти прогонов с небольшими правками формулировки.
Генерацию не стоит продолжать, если объект уже потерял форму или персонаж заметно изменился между кадрами — сначала нужно исправить исходную картинку, упростить описание движения или заменить референс на более чёткий. Шестой этап — собрать лучшие фрагменты в редакторе и проверить экспорт: формат файла, пропорции кадра, наличие водяного знака, звуковую дорожку и субтитры, если они нужны.
Несколько коротких сцен почти всегда надёжнее одного длинного запроса: модель стабильнее держит персонажа и композицию на коротком отрезке, чем на протяжённой сцене с множеством действий. Где сделать видео с нейросетью для серийного выпуска контента — там, где можно быстро повторить этот шестиэтапный цикл без лишних переключений между сервисами. Перед публикацией стоит также свериться с правами на исходные изображения, если они загружены не из собственного архива.
Типичные ошибки и ограничения ИИ-видео
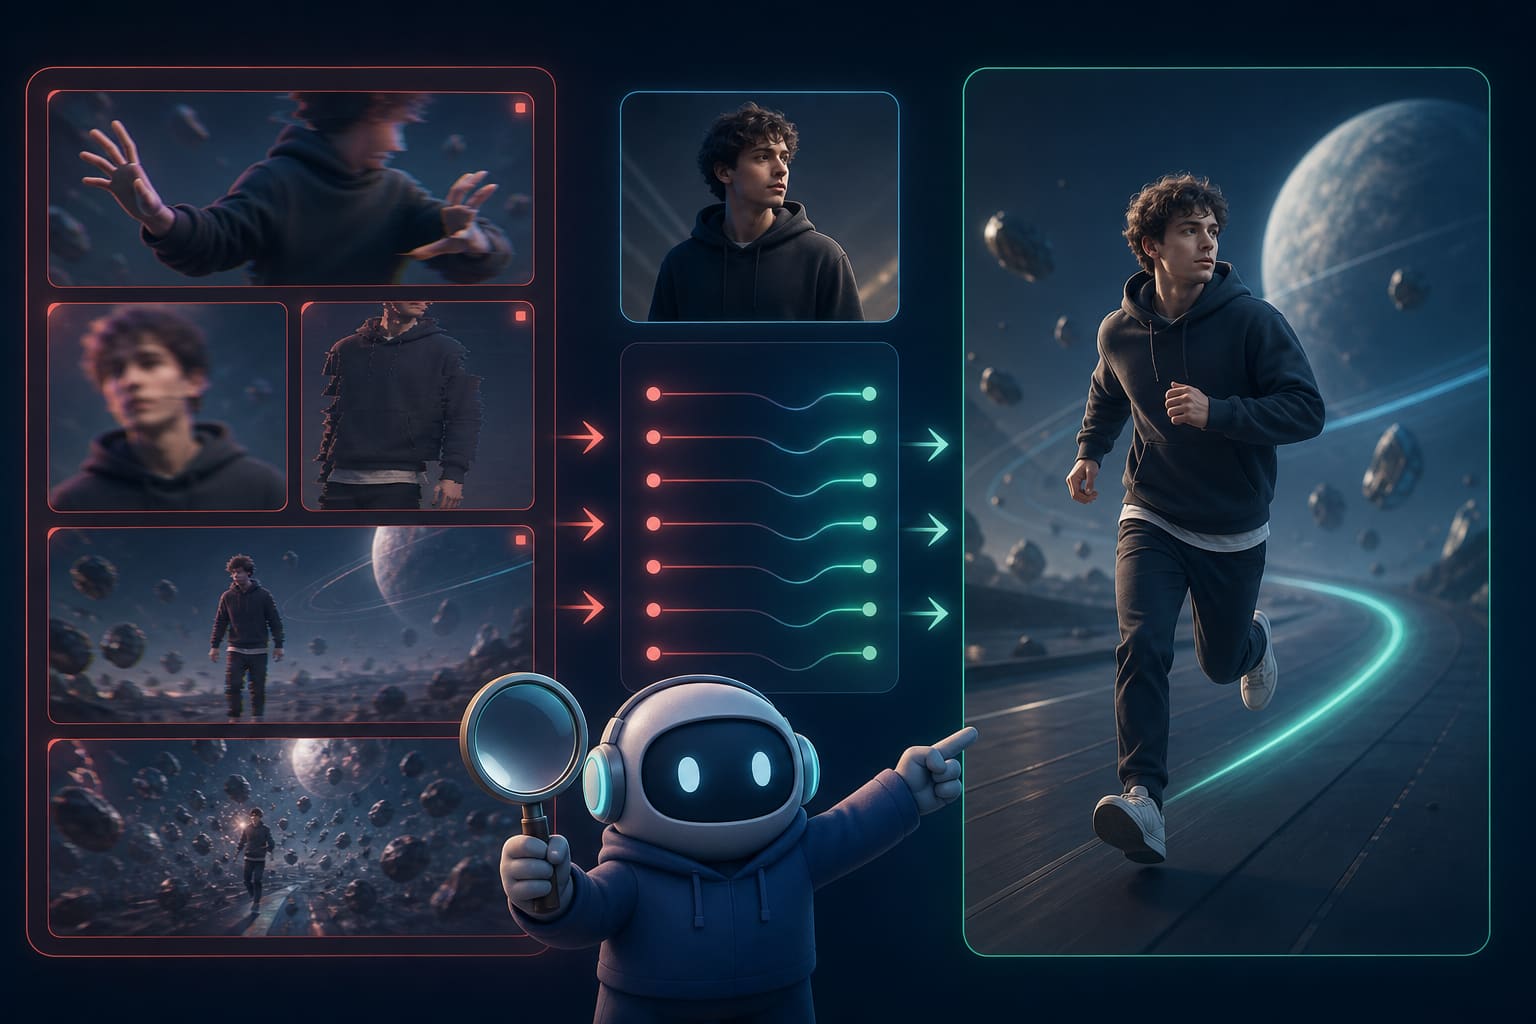
Большинство неудачных роликов портят одни и те же восемь ошибок: слишком общий промпт без деталей, несколько действий в одной сцене одновременно, отсутствие описания камеры, мелкий текст в кадре, который модель не воспроизводит точно, резкая смена лица или одежды между кадрами, неправильный формат для соцсетей, попытка получить длинный фильм одним запросом и отсутствие проверки звука и прав на загруженные изображения перед публикацией.
Ограничения генеративных моделей стоит знать заранее, а не считать их неисправностью сервиса. Физика объектов и кисти рук могут искажаться — это особенность текущего поколения нейросетей для видео, а не баг конкретного продукта. Надписи в кадре часто требуют ручного добавления в монтаже, потому что модель воспроизводит текст приблизительно. Персонаж не всегда сохраняется идентично между отдельными сценами, а доступность функций и тарифы меняются быстрее, чем обновляются обзоры.
Исправление почти всегда одно и то же: сократить сцену до одного действия, зафиксировать референс изображением, а не словесным описанием, описать ровно одно движение за раз, использовать стартовый и финальный кадр там, где это доступно, и повторить генерацию с другой формулировкой промпта вместо того, чтобы считать первую попытку окончательной.
Артефакты — размытые пальцы, плавающий фон, странная тень — не повод считать сервис сломанным. Это нормальная часть работы с генеративным видео, и способ борьбы с ними один: короче сцена, точнее промпт, больше попыток.
Как выбрать нейросеть: короткая матрица решений
Для реалистичной кинематографичной сцены с движением камеры и атмосферой подходит Sora или Veo при наличии доступа к ним. Для управляемого движения, нескольких планов и устойчивого персонажа — Kling. Для итеративной работы и креативного продакшена, где важно быстро перебрать варианты — Runway. Для регулярного тестирования нескольких моделей без создания пяти отдельных аккаунтов — ModelStation.
Рекомендация всегда зависит от исходных материалов, бюджета и требований к русской речи в кадре. Через какой ии можно сделать видео с диалогом на русском языке без переозвучки — вопрос, который стоит проверить тестовой генерацией перед тем, как платить за полный тариф.
Короткий алгоритм выбора: сначала определить тип входа — текст или готовое изображение; затем формат — горизонтальный ролик или вертикальный для соцсетей; затем требования к звуку и устойчивости персонажа между сценами; и только после этого проверить доступ из региона и реальную стоимость генерации, а не ориентир по рекламе сервиса. Нейросети для видео выбирают не по названию модели или месту в рейтинге, а по совпадению с этим набором условий.
Для коротких роликов и вертикального формата
Вертикальный ролик для сторис или Reels требует короткой сцены на три-восемь секунд, крупного объекта в центре кадра, безопасных полей по краям под интерфейс соцсети и быстрого визуального хука в первую секунду. Понятное действие героя — шаг, поворот, жест — работает лучше абстрактной атмосферы.
Генератор создаёт только исходник. Финальные титры, логотип бренда и точные цены товара лучше добавлять уже в редакторе после генерации, потому что мелкий текст в самой модели воспроизводится ненадёжно и может исказиться при повторном рендере.
Для рекламы и карточек товаров
Узнаваемость товара сохраняется через чистый референс без лишнего фона, одно описанное действие вместо нескольких одновременных и отказ от сложных надписей прямо в кадре. После генерации стоит проверить форму упаковки отдельно — модель иногда слегка меняет пропорции предмета между кадрами.
Ролик должен демонстрировать конкретную пользу товара — как он открывается, как выглядит в руке, как меняет цвет при повороте — а не только создавать красивую атмосферу вокруг продукта без функционального смысла.
Для аватаров и обучающих материалов
Аватарный формат требует стабильной речи без обрывов, точной синхронизации губ с произносимым текстом, чистого звука без фонового шума, читаемых субтитров, спокойного нейтрального фона и единого визуального образа ведущего на протяжении всего ролика.
Аватарные платформы устроены иначе, чем генераторы кинематографичных сцен: они оптимизированы под длинную статичную речь, а не под динамичное движение камеры и смену планов, поэтому смешивать их задачи не стоит.
Текст-видео против изображения-видео
Чистое текстовое описание даёт больше творческой свободы, когда исходного изображения нет и сцену нужно придумать с нуля. Фотография или иллюстрация в основе лучше сохраняет конкретный объект — лицо человека, форму товара, цвет упаковки — но требует аккуратного описания именно движения, а не повторного пересказа того, что уже видно на картинке.
Выбор между режимами определяется наличием исходника: есть точный референс — используется image-to-video, нет — text-to-video с подробным описанием сцены.
Звук, субтитры и финальный монтаж
Звук может быть сгенерирован самой моделью, как у Veo 3.1 и Kling с native audio, либо добавлен отдельно в редакторе после генерации видеоряда. Оба пути рабочие, но требуют проверки: сгенерированный звук стоит прослушать на предмет синхронизации с движением губ.
Субтитры, логотипы, юридические дисклеймеры и точные надписи лучше контролировать на этапе монтажа вручную, а не рассчитывать, что модель воспроизведёт их корректно прямо в кадре.
Как сравнивать две модели честно
Честное сравнение требует единой тестовой сцены, одинакового промпта, одинакового референсного изображения, одинакового формата кадра и равного числа попыток для каждой модели — иначе сравнение превращается в случайный выбор лучшего из разного количества попыток.
Оценивать стоит не впечатление от одного удачного кадра, а стабильность результата при повторении, управляемость через параметры движения, скорость генерации и фактический расход кредитов на один приемлемый результат.
Что проверять перед оплатой
Перед оплатой тарифа стоит проверить количество кредитов в пакете, доступное разрешение, наличие водяного знака на бесплатном и платном уровне, разрешение на коммерческое использование результата, срок хранения готовых файлов на сервере, формат экспорта и фактическую доступность оплаты из России.
Цену подписки и цену отдельной генерации нельзя путать: месячный тариф может стоить фиксированную сумму, а одна неудачная генерация всё равно спишет часть лимита кредитов независимо от итогового результата.
Как сохранить единого персонажа
Сохранить одного и того же героя между сценами помогает связка из нескольких приёмов: референсное изображение лица и одежды, повторение описания внешности в каждом новом промпте, одинаковый стиль одежды в тексте запроса, использование стартового кадра предыдущей сцены и ограничение числа одновременных изменений — не менять причёску и одежду в одной генерации.
Для длинной истории сюжет разбивают на короткие планы по три-пять секунд каждый, а не пытаются удержать персонажа стабильным на протяжении минуты в одной генерации.
Как работать с несколькими сценами
Схема работы с несколькими сценами простая: каждый план генерируется отдельно, из нескольких дублей отбирается удачный, переходы между сценами проверяются на совпадение освещения и положения персонажа, а финальная сборка происходит уже в видеоредакторе.
Попытка получить готовый фильм одним запросом почти всегда заканчивается потерей контроля над деталями — надёжнее собрать результат из пяти коротких, но предсказуемых фрагментов.
Итог
Выбор места для создания ИИ-видео определяется задачей, а не модой на конкретный бренд. Для кинематографичной сцены с движением камеры подходит Sora, для видео со звуком и заданными кадрами — Veo, для управляемого движения и нескольких планов — Kling, для итеративного продакшена — Runway.
- Пять сценариев использования — текст-видео, изображение-видео, продолжение ролика, аватар с речью и монтаж текстовыми командами — требуют разных инструментов, и смешивать критерии выбора между ними не стоит.
- Один промпт редко создаёт готовый фильм: результат — короткий фрагмент, который нужно продлить, повторить или собрать с другими сценами в монтаже.
- Для российского пользователя ключевые ограничения — английский язык промпта даже при русском интерфейсе, зависимость оплаты от карты и региона, и лимиты бесплатного режима по разрешению и числу попыток.
- Рабочая формула промпта из девяти элементов — объект, действие, окружение, стиль, камера, свет, композиция, длительность, формат — снижает число неудачных генераций сильнее, чем просто длинный текст.
- Регулярное тестирование нескольких моделей под одну задачу удобнее вести через единый интерфейс с общим балансом, а не через пять отдельных подписок.
Данные проверены на октябрь 2026 года.