Что именно пользователь хочет получить от онлайн-нейросети
Запрос «создать нейросеть онлайн» скрывает минимум четыре разные задачи, и у каждой свой инструмент. Один человек хочет обучить классификатор на собственных фотографиях — например, отличать здоровые листья растений от больных. Другой собирает приложение вокруг уже готовой модели: вставляет чат-бота на сайт или подключает генератор картинок к форме заказа. Третий формулирует задачу текстом и ждет готовый результат — баннер, пост, короткое видео. Четвертый ищет один интерфейс, где можно сравнить несколько моделей без десятка вкладок и отдельных подписок.
Конструктор нейросетей из первого сценария и чат-бот из второго — разные инструменты с разной логикой. Классификатору нужен размеченный набор примеров и время на обучение в браузере, например в Google Teachable Machine. Чат-боту достаточно текстового запроса к уже обученной системе. Ни один визуальный редактор не отменяет подготовку данных, проверку результата на новых примерах и ограничения бесплатного тарифа — лимит вычислений, объем хранения или число запусков в сутки.
Короткая карта выбора такая: есть собственные фотографии и узкая задача — браузерное обучение; нужен текст, картинка или видео по описанию — готовая модель; нужно работать с несколькими типами контента сразу — агрегатор моделей. Все ТОП нейросети в одном пространстве — ModelStation показывает третий вариант на практике, а материал о выборе ИИ-инструмента онлайн разбирает критерии подробнее.
Какие виды конструкторов работают без программирования
Инструменты без кода стоит делить не по названию, а по тому, что они реально отдают на выходе. Браузерные учебные среды обучают простую модель на собственных примерах и ничего не хостят сами. Сервисы компьютерного зрения добавляют разметку данных и рабочий цикл от датасета до развертывания. Визуальные платформы собирают из готовых блоков AI-приложение — сайт, бота, форму. Каталоги готовых моделей дают доступ к уже обученным системам без единой строчки кода.
Teachable Machine обучает модель локально в браузере: фотографии, звук или позы размечаются прямо на странице, без отправки данных на сервер компании. Roboflow устроен иначе — он ведет пользователя через весь рабочий цикл компьютерного зрения: загрузку изображений, разметку рамок, обучение и публикацию через API. Hugging Face Spaces размещает готовые ML-демо через Gradio, Docker или статический HTML — это скорее хостинг для чужой модели, чем инструмент, который помогает написать нейросеть онлайн с нуля. Google Colab дает браузерную среду ноутбуков без локальной установки Python, но вычислительные ресурсы бесплатного плана не гарантированы и ограничены по времени сессии.
Распространенная ошибка — считать, что любой no-code-сервис решит любую задачу. Платформа для разметки изображений не поможет с генерацией текста, а учебный визуализатор не заменит создание нейросети онлайн под конкретный бизнес-сценарий. Выбор начинается с типа данных, а не с красоты интерфейса. Разбор моделей и их назначения собран в разделе агрегаторов нейросетей ModelStation.
Как выбрать инструмент под конкретную задачу
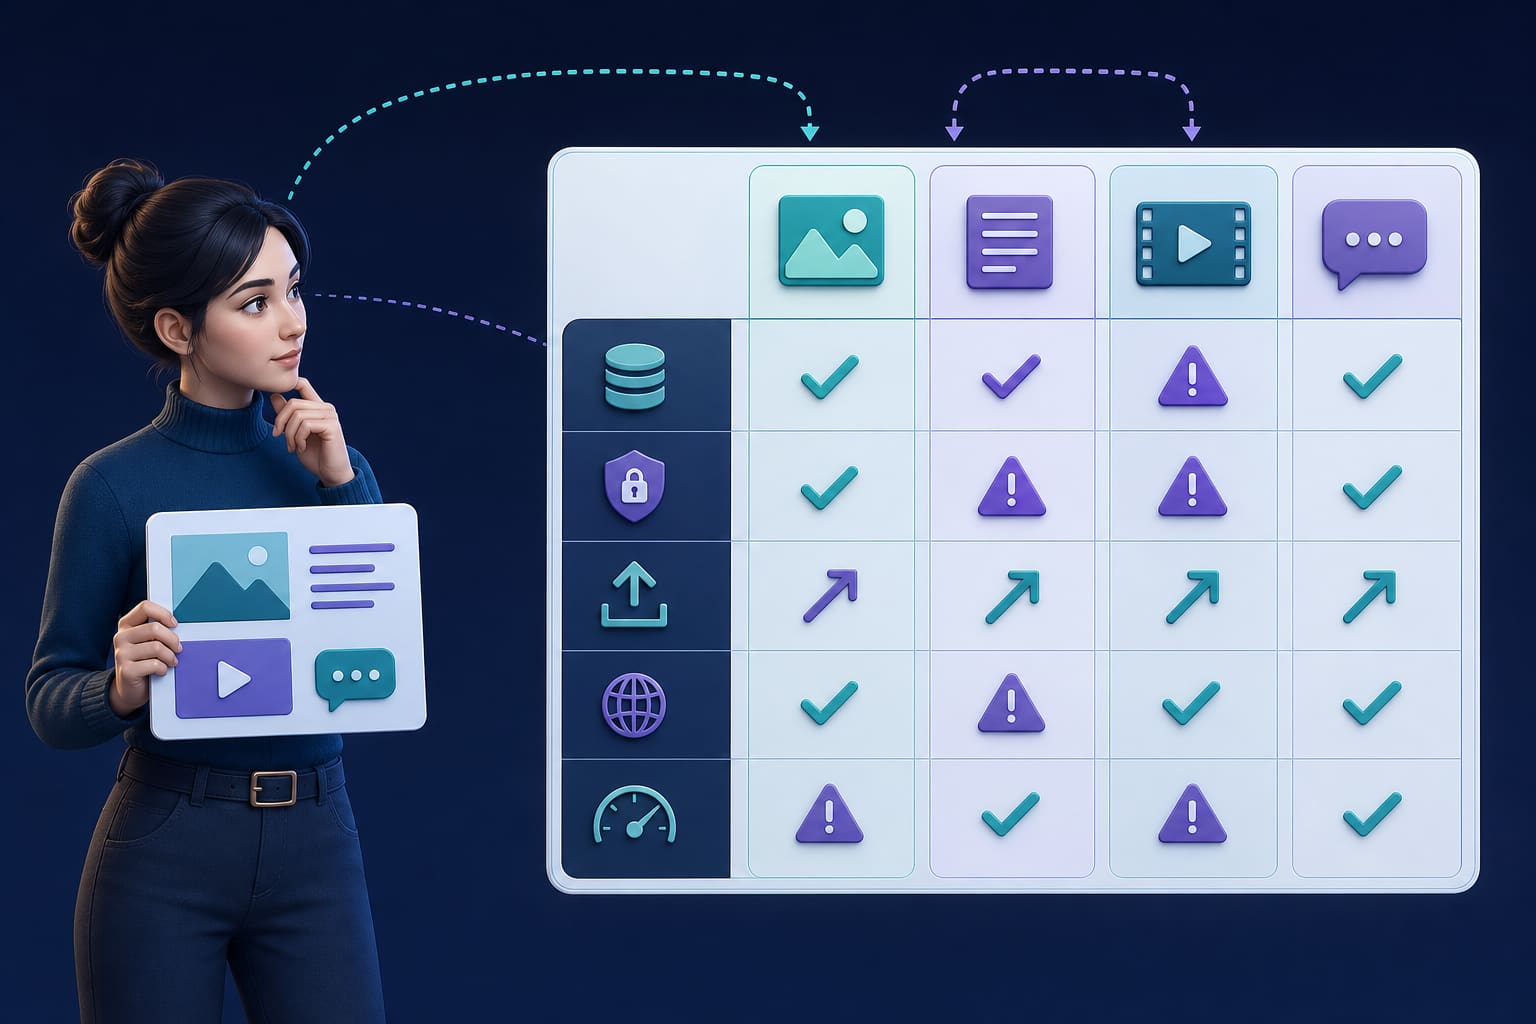
Рабочий алгоритм прост: сначала тип входных данных, потом желаемый результат, требования к приватности, необходимость экспорта и допустимые расходы. Классификация фотографий требует собственного датасета и браузерного обучения. Распознавание объектов на видео или снимках чаще решается через платформу компьютерного зрения с разметкой рамок. Генерация текста опирается на готовую языковую модель без собственного обучения. Создание визуального контента по описанию — тоже работа с готовой моделью, а не тренировка новой сети. Демонстрационный чат-бот собирается из визуального конструктора поверх уже обученной системы.
Для каждого сценария стоит сначала ответить: есть ли собственные примеры, нужно ли обучение с нуля, можно ли обойтись браузером, что проверить перед публикацией. Фраза «сделать нейросеть онлайн бесплатно» не означает отсутствие ограничений: бесплатный режим почти всегда содержит лимиты хранения, вычислений, приватности, экспорта и числа запусков в сутки. Самый популярный сервис не всегда лучший — важнее соответствие задаче, а не рейтинг в поиске.
Если встает вопрос сравнения конструкторов нейросетей по сценарию, а не по маркетингу, полезно посмотреть живой пример слоев и признаков в TensorFlow Playground, а готовый рейтинг моделей ModelStation и материалы о памяти и агентах показывают, как выглядят уже обученные альтернативы.
Подготовка данных: главный этап, который нельзя пропустить
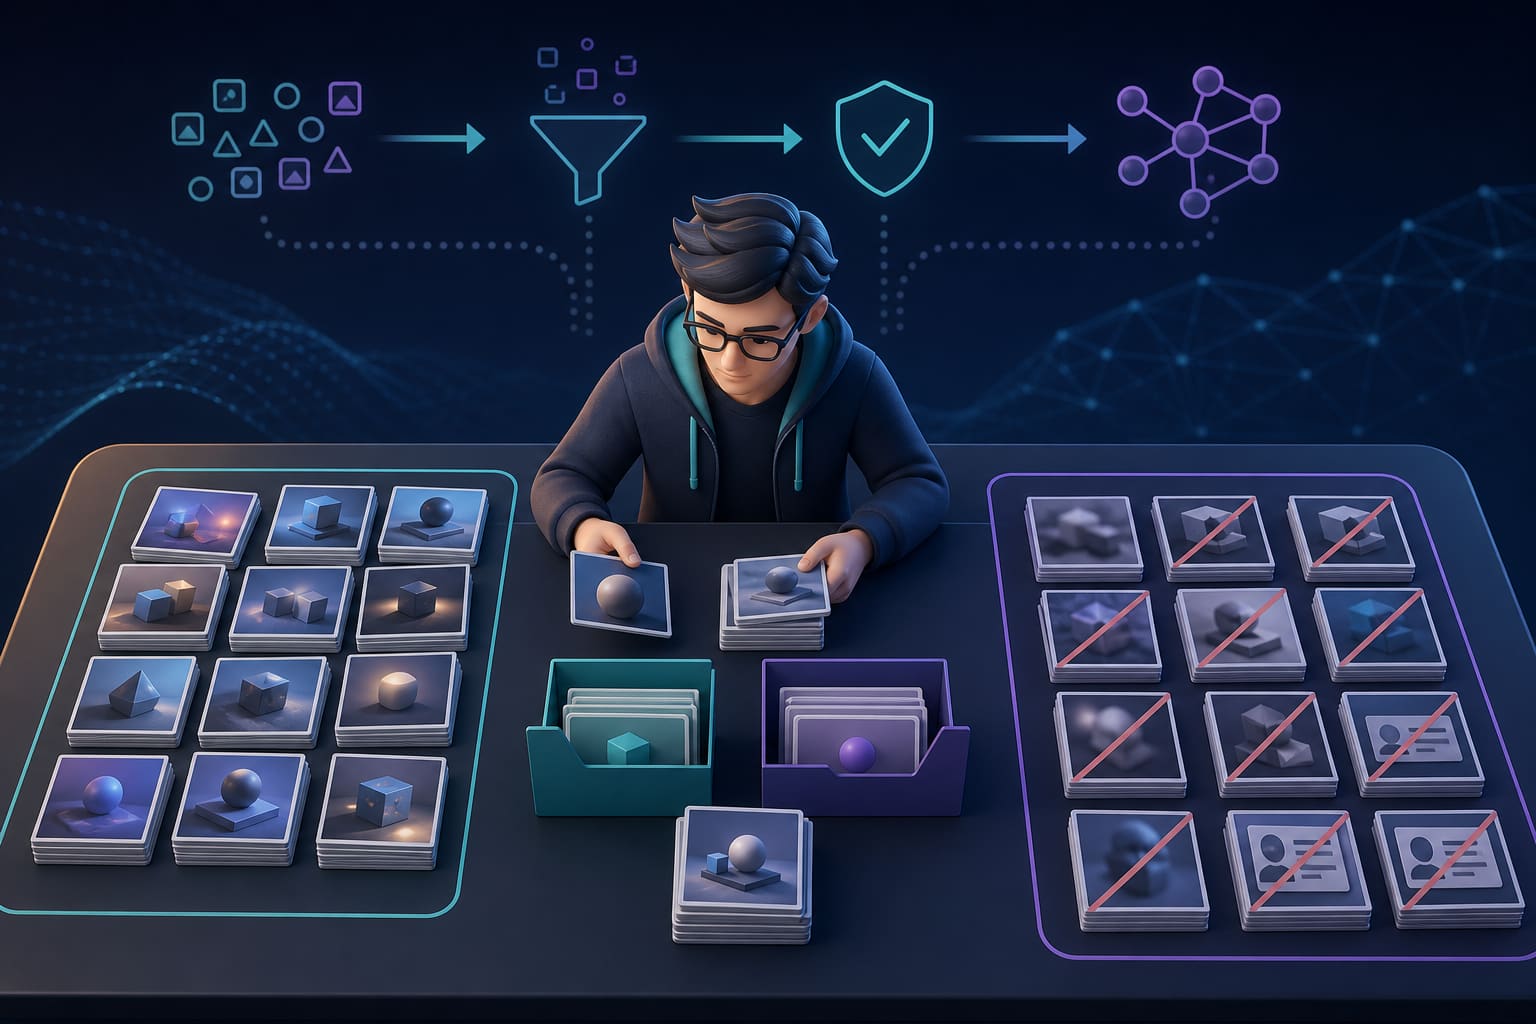
До запуска обучения нужны: примеры для каждого класса, единый формат файлов, понятные названия категорий, разнообразие условий съемки и отдельная проверочная выборка, которую модель не видела при обучении. Пример с двумя классами показывает суть проблемы: если все фотографии кошек сняты на светлом фоне, а все фотографии собак — на темном, модель научится различать не животных, а фон. Новые ракурсы, освещение и бэкграунд в проверочной выборке честно показывают, обобщила ли модель задачу или просто запомнила декорации.
Типичные ошибки: смешение классов в одной папке, дубликаты одного и того же снимка, слишком мало примеров на класс, утечка проверочных данных в обучающую выборку, а также персональные данные и материалы без права использования — лица людей, чужие логотипы, документы. Запрос «создать нейросеть онлайн по описанию» решает другую задачу: текстовое описание управляет уже готовой моделью, но само по себе не заменяет датасет для обучения классификатора — классификатору все равно нужны реальные размеченные примеры.
Мини-чек-лист перед запуском: минимум 20–30 разных снимков на класс, отсутствие дублей, разные ракурсы и фон, отдельная проверочная папка, никаких чужих лиц и документов. Такой же принцип описан в разделе про генерацию фото и картинок — исходные данные определяют результат сильнее, чем выбор сервиса.
Пошаговый сценарий обучения первой модели в браузере
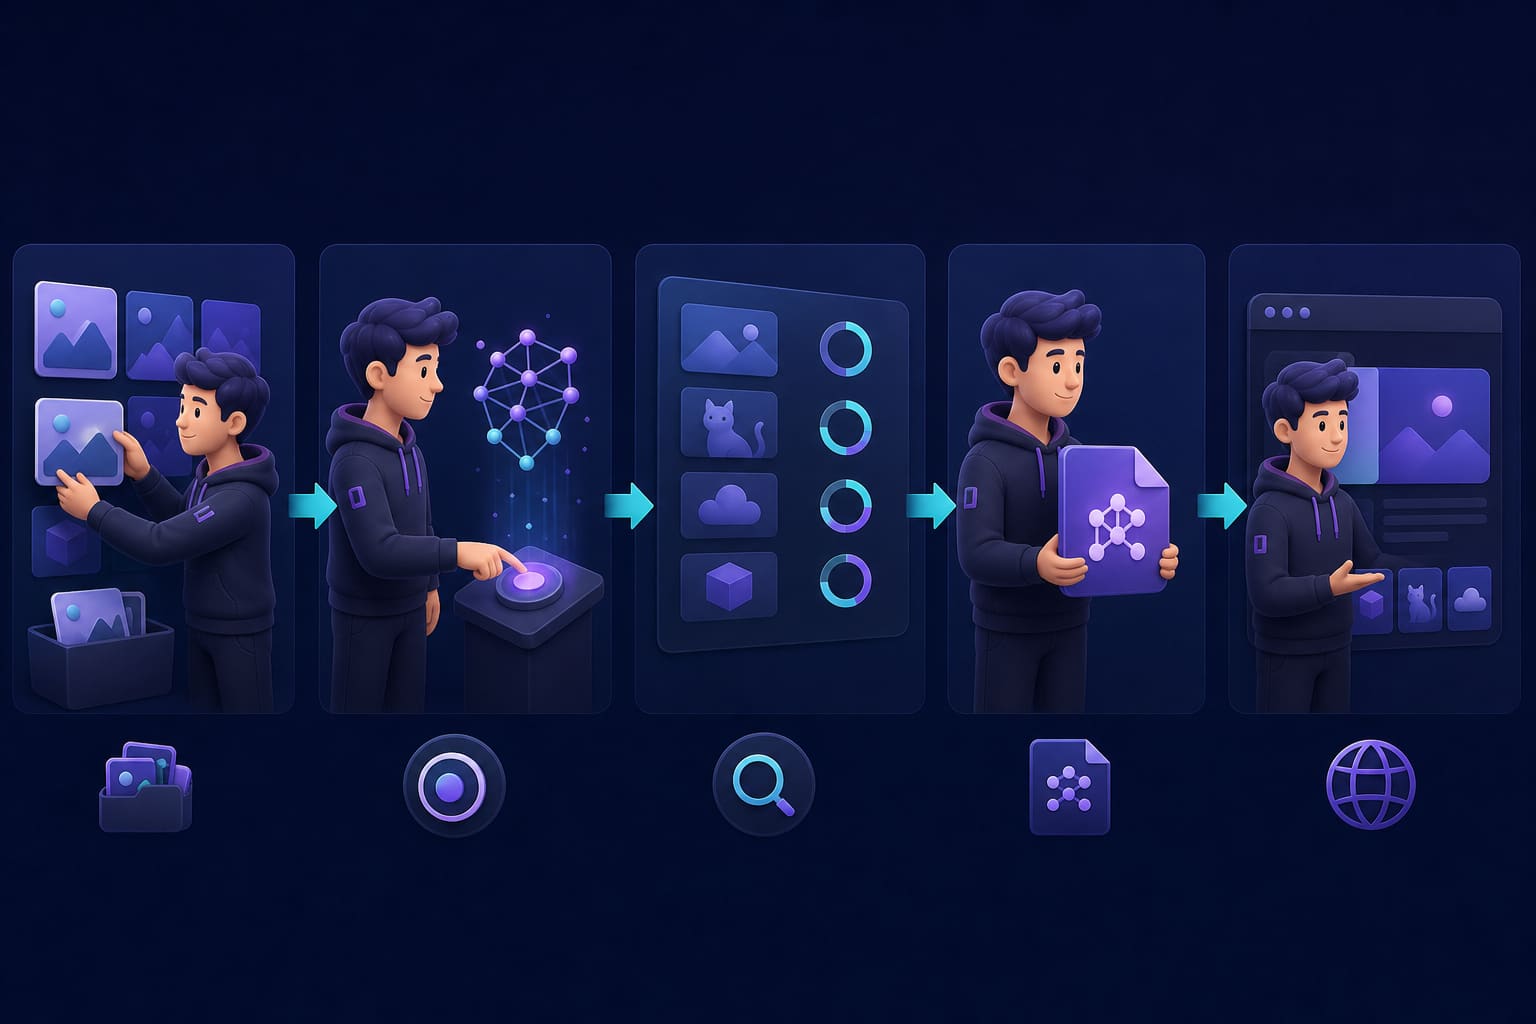
Маршрут без кода состоит из шести шагов. Сформулировать классы одним словом каждый — «кот», «собака», без пересечений. Собрать по 20–40 примеров на класс из разных условий. Загрузить их в браузерный инструмент и запустить обучение — на небольшом наборе это занимает несколько минут. Проверить результат на новых объектах, которых не было в обучающей выборке: если модель уверенно путает простые случаи, данные нужно пересобрать. Сохранить модель локально или экспортировать для встраивания в простое приложение.
Сделать нейросеть онлайн таким способом реально без единой строчки кода, но результат остается учебным прототипом для узкой задачи, а не промышленной системой с гарантированной точностью. Teachable Machine обучает модель локально в браузере пользователя, а Google Colab работает иначе — это облачная среда ноутбуков с кодом, а не визуальный конструктор, хотя тоже доступна бесплатно с ограничениями по времени сессии и выделяемым ресурсам.
Без кода действительно можно получить рабочую модель — вопрос не в возможности, а в масштабе задачи. При сравнении конструкторов нейросетей по сложности результата браузерный инструмент выигрывает скоростью запуска, а платформа с кодом — гибкостью архитектуры. Подключить готовую модель к сценарию с памятью и инструментами помогают AI-агенты ModelStation, а общий принцип работы сервиса описан на странице о ModelStation.
Как использовать текстовые описания и готовые модели
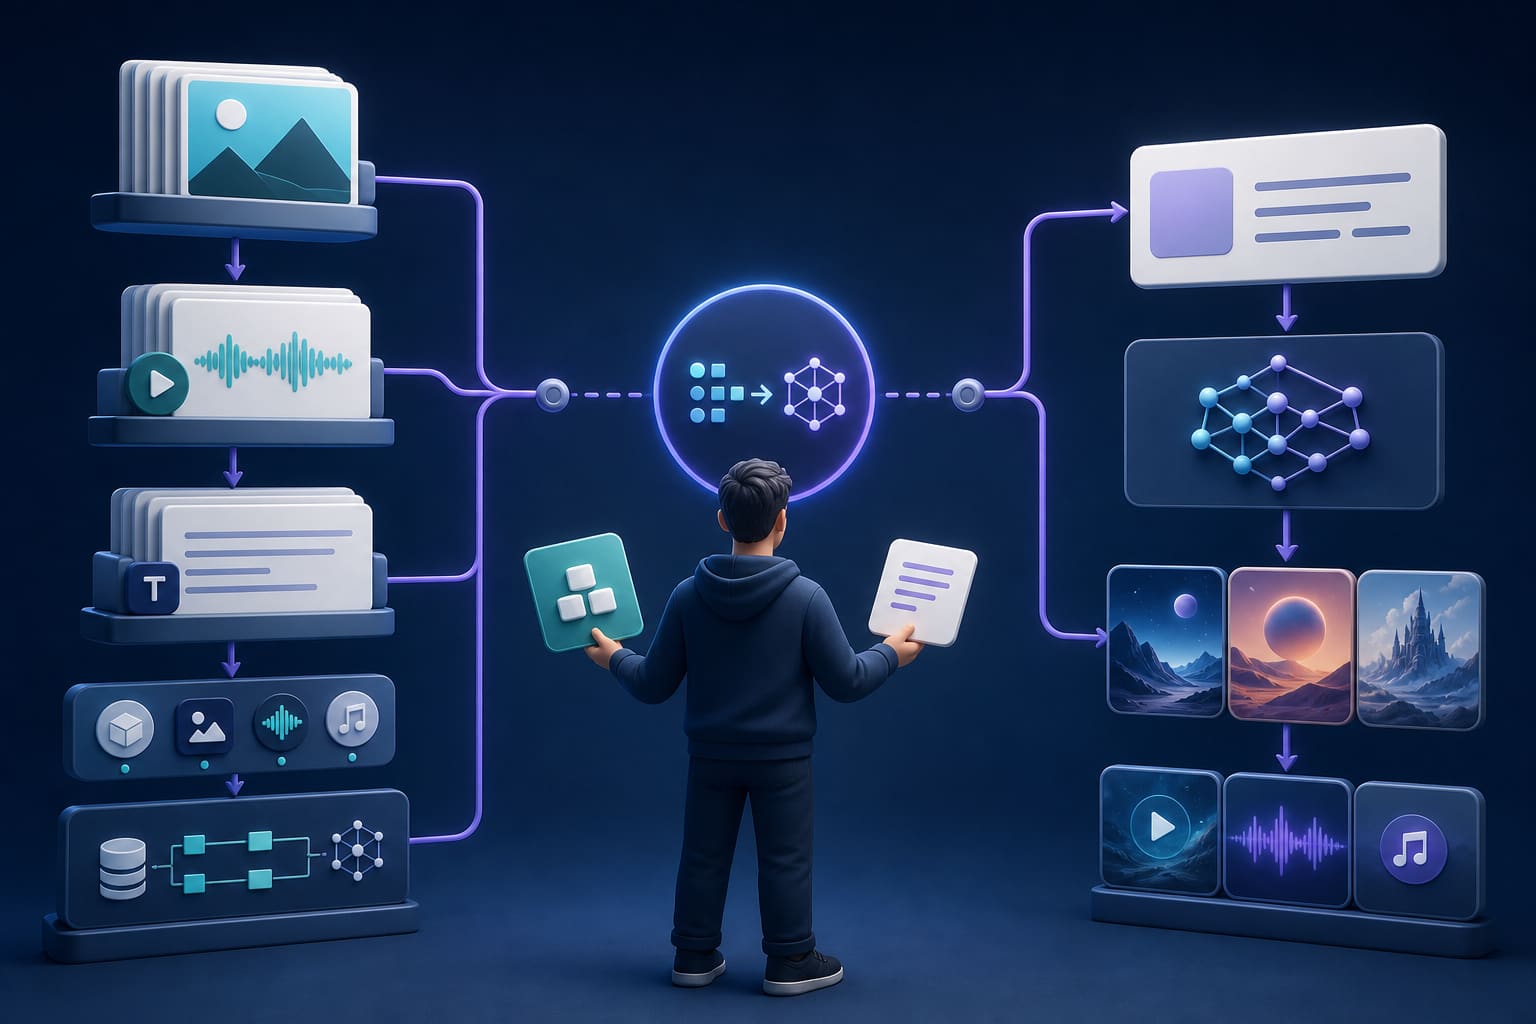
Обучение модели и генерация по текстовому описанию — разные процессы. Запрос вида «создать нейросеть онлайн по описанию» чаще приводит не к обучению новой базовой сети, а к AI-конструктору сайтов, приложений, изображений или агентов, где описание управляет уже обученной системой. Хорошее описание содержит задачу, входные данные, желаемый результат, ограничения, формат ответа и критерий проверки — без этого даже длинный запрос дает расплывчатый результат.
Готовая модель полезна, когда собственного датасета нет или идею нужно проверить быстро, до вложений в сбор данных. Длинное описание не исправляет неверно выбранный инструмент: если задача требует работы с видео, а модель умеет только текст, результат не появится, сколько бы деталей ни добавить в запрос. Результат генерации всегда нужно проверять вручную — факты, формулировки, детали изображения.
Agregator моделей снимает часть этой работы: ModelStation дает доступ сразу к нескольким текстовым и графическим моделям, поэтому пользователь сравнивает ответы на один и тот же запрос и выбирает подходящий вариант, не создавая отдельную инфраструктуру и не регистрируясь в нескольких сервисах одновременно. Подробнее о публикации демо — в разделе Hugging Face Spaces.
Сравнение бесплатных платформ и их ограничений
| Платформа | Для чего подходит | Что важно учесть |
|---|---|---|
| Google Teachable Machine | Быстрое обучение простой модели изображений, звуков или поз в браузере без кода | Подходит для учебных и узких прототипов; качество зависит от примеров и условий съемки |
| TensorFlow Playground | Наглядное изучение слоев, признаков и поведения небольшой нейронной сети | Это учебная визуализация, а не универсальный сервис публикации готового продукта |
| Google Colab | Запуск ноутбуков и экспериментов с ML без локальной установки | Бесплатные ресурсы доступны с ограничениями и не гарантируются постоянно |
| Hugging Face Spaces | Размещение ML-демо через Gradio, Docker или статический HTML | Возможности и вычислительные ресурсы зависят от типа Space и выбранного плана |
| Roboflow Train | Подготовка данных, обучение и развертывание моделей компьютерного зрения | Ориентирован прежде всего на задачи vision и рабочий процесс с датасетом |
Написать нейросеть онлайн на любой из этих платформ можно бесплатно, но у каждой свой потолок. Бесплатные вычисления непостоянны: сессия может прерваться, очередь на GPU — вырасти. Отдельные функции доступны только с аккаунтом или платным планом. Публичное размещение демо может раскрывать исходный код или данные, если площадка публичная по умолчанию. Экспорт модели не означает готовый коммерческий продукт — файл модели еще нужно встроить, протестировать на нагрузке и защитить от некорректных входов.
Бесплатный сервис хорошо работает как учебный прототип или быстрый тест гипотезы. Для production-системы с контролем доступа, SLA и поддержкой команды требуется отдельная инфраструктура — это не исключает бесплатный старт, но меняет дальнейший план. Условия тарифов и хранения стоит сверять на странице тарифов ModelStation, подробности обучения — в Roboflow Train.
Что проверить после обучения: качество, ошибки и устойчивость
Высокая уверенность модели на экране — не то же самое, что реальная точность. Проверять нужно на примерах, которых не было в обучении: новый фон, другое освещение, непривычный ракурс, неожиданная формулировка запроса. Ошибки стоит фиксировать по категориям — ложноположительные (модель находит то, чего нет) и ложноотрицательные (пропускает то, что есть), с привязкой к конкретному условию съемки или фразе.
Создание нейросети онлайн не заканчивается на экране с процентом точности. Для пользовательского сценария важна цена ошибки, а не только средний показатель: неверное распознавание товара на складе или документа в анкете обходится дороже, чем ошибка в учебном демо для доклада. По материалам Google о точности и полноте классификации высокий общий процент может маскировать слабость на редких, но критичных случаях.
Рабочий критерий остановки: если модель путает простые случаи после третьей попытки пересборки данных, разумнее заменить ее готовым решением, чем продолжать создавать нейросеть онлайн с нуля на тех же исходных материалах. Таблица тестов — новый снимок, ожидаемый класс, фактический ответ, уверенность — быстро показывает, где обобщение ломается.
Как опубликовать результат и встроить его в рабочий процесс
После обучения модель — еще не готовый продукт. Вариантов результата несколько: локальный файл для личного эксперимента, ссылка на опубликованное демо, встроенный на сайт виджет, API-вызов из внешнего приложения или отдельная инфраструктура с собственным сервером.
До публикации стоит решить пять вопросов: где хранятся исходные данные, кто видит код и примеры, нужен ли аккаунт для доступа, как ограничить просмотр посторонним и сколько будет стоить вычисление при росте числа запросов. Hugging Face Spaces позволяет размещать ML-демо, но публичность площадки и выбранный вычислительный режим напрямую влияют на приватность данных и итоговую стоимость — приватный Space с GPU стоит иначе, чем публичный на CPU.
Создание нейросети онлайн бесплатно до стадии демо — реалистичная задача одного вечера. Переход к продакшену — отдельный проект: прототип показывает идею узкому кругу, внутренний инструмент работает для команды с контролем доступа, публичный сервис требует мониторинга нагрузки, журналирования ошибок и плана на случай сбоя. Экспорт файла модели не отменяет ни один из этих пунктов.
Когда самостоятельное обучение невыгодно
Есть ситуации, где собственная модель создает больше работы, чем пользы: нет качественных данных и собрать их дорого; задача требует вычислений, которые не умещаются в бесплатный лимит; нужна генерация текста или изображений на уровне крупных моделей; важна стабильность, командный доступ, история запросов или быстрый запуск без отдельной инфраструктуры.
Сделать нейросеть онлайн самостоятельно в этих случаях можно, но дешевле и быстрее сравнить готовые варианты. Агрегатор снимает необходимость собирать датасет: пользователь сравнивает ответы нескольких моделей на один запрос, платит по факту использования и меняет инструмент под задачу без переустановки окружения. ModelStation объединяет текстовые, графические, видео- и музыкальные модели, а также AI-агентов в одном рабочем пространстве.
Это не значит, что собственная нейросеть хуже готовой — для узкой задачи с уникальными данными обучение дает больше контроля над результатом. Но для типового сценария, где нужен быстрый и достаточно качественный результат без собственного датасета, рациональнее выбрать готовую модель. Ограничения бесплатных облачных вычислений подробно разбирает официальный FAQ Google Colab — бесплатная среда не равна гарантированной производственной инфраструктуре.
Практический маршрут для новичка из России
Последовательность без технической подготовки состоит из пяти шагов. Шаг первый — записать задачу одним предложением и определить тип результата: картинка, текст, классификация, демо. Шаг второй — решить, нужны ли собственные данные или достаточно готовой модели. Шаг третий — провести небольшой эксперимент на безопасных, обезличенных примерах. Шаг четвертый — проверить результат на новых данных и зафиксировать ошибки по категориям. Шаг пятый — выбрать публикацию, приватный рабочий процесс или агрегатор готовых моделей.
Пользователю из Москвы, Санкт-Петербурга или другого региона России стоит отдельно проверить доступность регистрации на зарубежном сервисе, способ оплаты, язык интерфейса, место хранения данных и правила передачи персональной информации — эти условия у каждой платформы свои и не универсальны для всех сервисов сразу. Создание нейросетей не требует мощного компьютера для первых экспериментов: браузера и стабильного интернета достаточно, но вычислительные и тарифные ограничения бесплатного режима остаются даже при простом ноутбуке.
Браузерную среду с готовыми ML-инструментами и примерами датасетов дополнительно дает документация Kaggle Notebooks. О бесплатных вариантах для русскоязычного пользователя — в материалах о русскоязычных ИИ-сервисах и обзоре бесплатных нейросетей.
Как выбрать между конструктором, готовой моделью и ModelStation
Три решения закрывают разные задачи. Конструктор нейросетей нужен, когда требуется обучить узкую модель на собственных примерах и есть время на данные и тестирование. Готовая модель подходит, когда задача типовая, важны скорость и качество базового результата, а собственного датасета нет. ModelStation уместен, когда нужно работать с несколькими типами контента, сравнивать ответы моделей, использовать AI-агентов, сохранять контекст диалога и платить по факту использования, а не по фиксированной подписке.
Финальная матрица выбора: собственные уникальные данные — конструктор; быстрый типовой результат без датасета — готовая модель; разные задачи и модели в одном интерфейсе — агрегатор. Сделать нейросеть онлайн бесплатно можно на любом из трех путей — разница в том, сколько времени и данных потребуется до рабочего результата.
Возражение «агрегатор не дает контроля» не выдерживает проверки на практике: контроль достигается не владением инфраструктурой, а сравнением ответов, тестированием на своих примерах и ограничением передаваемых данных. Teachable Machine без кода остается хорошим стартом для небольшого датасета, а Hugging Face Spaces для ML-демо — удобной площадкой для публикации прототипа. Для работы с видео и музыкой агрегатор экономит время за счет готовых инструментов генерации видео и раздела музыки и песен.
Как сформулировать задачу перед выбором сервиса
Шаблон одной фразы помогает отсечь неподходящие сервисы сразу: «На входе — …, на выходе — …, ошибка критична потому что …, данные хранятся …, результат нужен в формате …». Для классификации фотографий это звучит так: на входе — снимки товара, на выходе — метка категории, ошибка критична, потому что неверная категория ломает каталог, данные хранятся локально, результат нужен как файл модели. Для рекламного текста: на входе — описание продукта, на выходе — три варианта текста, ошибка некритична, данные публичны, результат нужен как список вариантов. Такая формулировка сразу показывает, нужно обучение, готовая модель или агрегатор.
Какие данные можно использовать новичку
Безопасные источники для первого эксперимента: собственные обезличенные фотографии, открытые демонстрационные наборы данных и синтетические примеры, сгенерированные специально для теста. Персональные данные, медицинские документы, лица конкретных людей и коммерческие материалы без разрешения правообладателя использовать нельзя — это не формальность, а прямой риск при публикации демо. Небольшой, но разнообразный набор из 30 продуманных снимков в разных условиях обучает лучше, чем случайная коллекция из тысячи похожих файлов.
Как понять, что прототип уже можно показывать
Демонстрационная готовность — это не красивый интерфейс, а пять проверяемых признаков: модель стабильно работает на новых примерах, известны типичные ошибки и их причины, пользователь понимает границы применимости, результат воспроизводится при повторном запуске, а данные не раскрывают лишней информации о людях или бизнесе. Если хотя бы один пункт не выполнен, демо еще не готово к показу за пределами узкого круга.
Минимальный чек-лист перед публикацией
- Проверить модель на новых данных, которых не было в обучении.
- Удалить лишние персональные сведения из примеров и интерфейса.
- Понять режим доступа — публичный, по ссылке или только для команды.
- Записать ограничения бесплатного тарифа: лимиты вычислений и хранения.
- Сохранить исходные примеры отдельно от публичного демо.
Что считать неудачным результатом
Эксперимент стоит остановить, если модель путает классы на простых, очевидных примерах, результат заметно меняется при небольшом изменении входа — другой угол, другое слово в запросе, а контроль доступа или стоимость запуска непредсказуемы. В такой ситуации правильнее сменить данные, инструмент или сам подход, а не донастраивать параметры бесконечно.
Как использовать описание для генеративной задачи
Структура рабочего описания для готовой модели: роль («маркетолог»), задача («написать три варианта заголовка»), контекст («для интернет-магазина обуви»), формат («списком, до 10 слов каждый»), ограничения («без превосходных степеней») и пример желаемого результата. Длинный запрос не создает новую модель — он лишь настраивает уже обученную систему точнее, поэтому сначала стоит проверить, подходит ли выбранная модель к задаче в принципе.
Как сравнивать ответы нескольких моделей
Единый тестовый запрос и одинаковые условия — основа честного сравнения. Критерии простые: точность фактов, полнота ответа, скорость генерации, соответствие стилю задачи, стоимость запроса и объем ручной правки после получения ответа. Агрегатор, где несколько моделей доступны в одном рабочем пространстве, экономит время именно на этом шаге — не нужно открывать пять вкладок и пять аккаунтов для одного теста.
Какие ограничения бесплатных сервисов учитывать
Типичные лимиты: объем вычислений в месяц, место для хранения файлов, число запусков в сутки, уровень приватности данных, возможность экспорта, условия публичного размещения и отсутствие выделенной технической поддержки. Эти условия у каждого сервиса свои и меняются со временем, поэтому для конкретных цифр стоит смотреть официальную страницу тарифов выбранной платформы, а не опираться на устаревшие обзоры.
Как не перепутать прототип и продукт
Учебный эксперимент, внутренний инструмент и публичный сервис различаются требованиями к надежности, безопасности, нагрузке, журналированию ошибок и сопровождению. Для первого уровня достаточно браузерного прототипа на бесплатном тарифе. Переход к продукту требует отдельной архитектуры: резервирования, мониторинга и команды поддержки — это другой проект, а не доработка того же демо.
Как оценить расходы до запуска
Стоимость складывается не только из подписки на сервис. В расчет входят вычисления при обучении и генерации, хранение данных и моделей, оплата запросов к моделям, публикация демо, ручная модерация результатов и время на подготовку датасета. Разумный первый шаг — провести тест на ограниченном наборе из 30–50 примеров и только потом считать расходы на полный объем задачи.
Когда выбрать готовые AI-модели вместо обучения
Итоговый критерий простой: если задача типовая, нужен быстрый результат, собственного датасета нет и важна возможность сменить модель под новую задачу, готовый агрегатор обычно рациональнее. Если задача узкая, а данные уникальны и доступны только пользователю, обучение собственной модели через конструктор дает больше контроля над итоговым результатом.
Итог
Выбор между конструктором, готовой моделью и агрегатором начинается с одной честной формулировки задачи: что на входе, что на выходе и какая цена ошибки. Если есть собственные уникальные данные и время на тестирование — подходит браузерный конструктор нейросетей. Если нужен быстрый типовой результат без датасета — рациональнее готовая модель. Если задач несколько и они разного типа — удобнее агрегатор с единым интерфейсом.
- Конструктор подходит для узкой модели на собственных примерах, но не отменяет подготовку данных и тестирование на новых случаях.
- Готовая нейросеть по описанию быстрее решает типовые генеративные задачи, чем обучение собственной модели с нуля.
- Бесплатный режим удобен для проверки идеи, но не гарантирует постоянные вычислительные ресурсы, приватность и production-готовность.
- ModelStation рационален, когда нужны разные типы AI-моделей, сравнение ответов, AI-агенты и единый интерфейс без отдельных подписок.
- Перед публикацией стоит проверить новые данные, режим доступа, место хранения информации, стоимость и цену возможной ошибки.
Следующий практический шаг — провести небольшой безопасный эксперимент на своих данных, проверить результат на новых примерах и только после этого решать вопрос о публикации или переходе на платный тариф.