Почему нейросеть не всегда описывает фото так, как ожидает пользователь
Пользователь загружает фотографию и получает фразу вроде «на изображении человек и улица», хотя ждал готовый alt-текст, карточку товара или подпись для поста. Разрыв между ожиданием и результатом возникает потому, что «описать фото» объединяет несколько разных задач: визуальное распознавание объектов, OCR для текста на снимке, генерацию короткой подписи и написание текста под конкретную площадку. Эти режимы работают по-разному, и запрос без уточнения цели почти всегда возвращает самый общий вариант описания.
Результат зависит от трёх вещей: качества исходного файла, формулировки запроса и выбранного режима модели. Тёмный, размытый или повёрнутый кадр снижает точность распознавания независимо от того, какая нейросеть его обрабатывает. Возражение «нейросеть сама всё поймёт» не выдерживает проверки: модель может ошибиться в количестве предметов на фото, прочитать мелкую надпись неточно или выдать уверенное предположение вместо факта — например, назвать материал, которого не видно на кадре.
Описание изображений нейросетью становится точным, когда читатель сначала решает, для чего нужен текст: для доступности сайта, для карточки маркетплейса, для соцсети или для архива. Только после этого выбирается инструмент и загружается файл. Подробный разбор того, как устроены разные ИИ-инструменты для изображений, даёт материал Все про нейросети: как выбрать ИИ-инструмент онлайн. В официальных ограничениях анализа изображений в ChatGPT прямо указано: точность падает на мелком тексте, сложной геометрии, панорамах и при подсчёте объектов — то есть ошибка в таких случаях не редкость, а ожидаемое поведение системы при описании нейросетью онлайн.
Какие задачи решает ИИ-анализ изображения
Одна и та же фотография может потребовать совершенно разных результатов, и делить инструменты стоит не по названиям сервисов, а по конечной задаче. Короткая подпись для соцсети, подробное описание сцены для архива, alt-текст для доступности, карточка товара, извлечение текста, список объектов или промпт для генерации — у каждого формата свои требования к длине, тону и степени точности.
Alt-текст — это одна нейтральная фраза без рекламных эпитетов, которая передаёт главный смысл кадра для программ чтения с экрана. Карточка товара требует перечисления видимых материалов, цвета, формы и особенностей без выдуманных характеристик бренда или состава. Для соцсетей нужен живой текст с настроением, но без утверждений о том, чего на кадре не видно. Архивное описание — нейтральный разбор людей, места и события, без домыслов о дате или имени. Промпт для генерации раскладывает сцену на композицию, свет, стиль и объекты.
Запрос «опиши фото» уступает запросу с ролью, длиной и ограничениями, потому что модель не знает, какой из перечисленных форматов нужен, и выбирает усреднённый вариант. Разобраться, как описать изображение онлайн под конкретную задачу, помогает раздел Изображения, которые работают на вашу идею, где показана разница между генерацией нового изображения и анализом готового кадра. Любое описание изображений, даже бесплатное, пригодно не потому, что звучит красиво, а потому, что соответствует задаче.
Лучшие бесплатные инструменты для описания фотографий в 2026 году
ChatGPT с загрузкой изображений удобен для диалога: пользователь прикрепляет фото, задаёт вопрос и может сразу уточнить ответ следующей репликой. Сервис хорошо держит контекст беседы, поэтому подходит для разовой задачи, где важно обсудить детали кадра. Gemini предлагает мультимодальный анализ с поддержкой PNG, JPEG, WEBP, HEIC и HEIF, решает задачи image captioning, visual question answering, классификации, обнаружения и сегментации объектов — но итоговую точность в документации к модели всё равно предлагают проверять вручную. Azure Vision рассчитан на программный анализ: он возвращает подписи, теги, OCR и координаты объектов через API, поэтому подходит для автоматизации, а не для разового диалога. ModelStation в этом ряду занимает нишу агрегатора: он даёт сравнение нейросетей для изображений в одном рабочем пространстве, без необходимости открывать несколько вкладок и аккаунтов.
Бесплатный доступ не означает одинаковые лимиты. У диалоговых сервисов важны план и аккаунт, у программных решений — API-ресурс и регион, у агрегатора расход зависит от выбранной модели и объёма обработки. ChatGPT и Gemini удобнее для диалога и уточнений, Azure Vision — для автоматизации и структурированных функций, а ModelStation — когда нужно сопоставить несколько ответов на одном фото. Ни один из вариантов не предлагает вечную бесплатность: условия стоит проверять в актуальном кабинете каждого сервиса. Рейтинг моделей по разным задачам собран на странице Какие нейросети лучшие для текста, генерации фото, видео и музыки.
| Инструмент | Основной сценарий | Что можно получить | Важное ограничение |
|---|---|---|---|
| ChatGPT | Диалоговый анализ загруженного фото | Ответы на вопросы, описание объектов, разбор документов и визуального содержимого | Результат может быть неточным при плохом качестве, мелком тексте и сложной геометрии |
| Gemini | Мультимодальный анализ и вопросы к изображению | Подпись, классификация, ответы по сцене, обнаружение объектов и сегментация | Формат и лимиты зависят от выбранной модели и способа передачи файла |
| Azure Vision | Программная обработка изображений | Подписи, OCR, теги, объекты и координаты обнаружения | Для API нужен ресурс Azure, регион и настройка доступа |
| ModelStation | Сравнение нескольких AI-моделей | Несколько вариантов описания и выбор результата под задачу | Условия доступа и стоимость зависят от выбранной модели и тарифа |
Подтверждают возможности сервисов официальная документация Gemini для анализа изображений и документация Azure Vision.
Как подготовить фото, чтобы нейросеть увидела больше деталей
Перед загрузкой стоит выбрать оригинал без сильного сжатия, повернуть кадр в правильную сторону, обрезать лишние поля и убедиться, что важные объекты ничем не закрыты. Если на фото есть мелкая надпись — этикетка, табличка, серийный номер — полезно сделать отдельный крупный фрагмент именно этого участка и отправить его вторым файлом. Нейросеть описание онлайн бесплатно получает не из названия файла и не из метаданных снимка: эти данные модель не читает, их всегда заменяет текстовый запрос.
Размытое, тёмное или перевёрнутое изображение снижает точность распознавания объектов и чтения текста: модель либо выдаёт общий ответ, либо ошибается в деталях, которые на резком кадре были бы различимы. Рабочий шаблон для первого запроса звучит так: «Опиши видимые объекты, их расположение, фон, цвета и текст. Не делай предположений о том, чего не видно». Эта формулировка задаёт границу между фактом и догадкой уже на старте работы с изображением.
Перед отправкой фото стоит убрать из кадра документы, номера телефонов, адреса, чужие лица и внутренние материалы компании, если они не нужны для анализа — приватность снимка не восстановить после того, как файл ушёл в сервис. Длинный запрос с десятком требований не повышает точность: модель путается в приоритетах, когда получает их все одновременно. Поэтому сначала формулируется главная задача, затем формат ответа, и только потом — ограничения и запреты. Примеры подготовки изображений для разных сценариев разобраны в материале Как использовать нейросети для генерации фото и картинок. Поддерживаемые форматы и ограничения по размеру файла описаны в требованиях для загрузки изображений в ChatGPT.
Как задать запрос и получить точное описание изображения
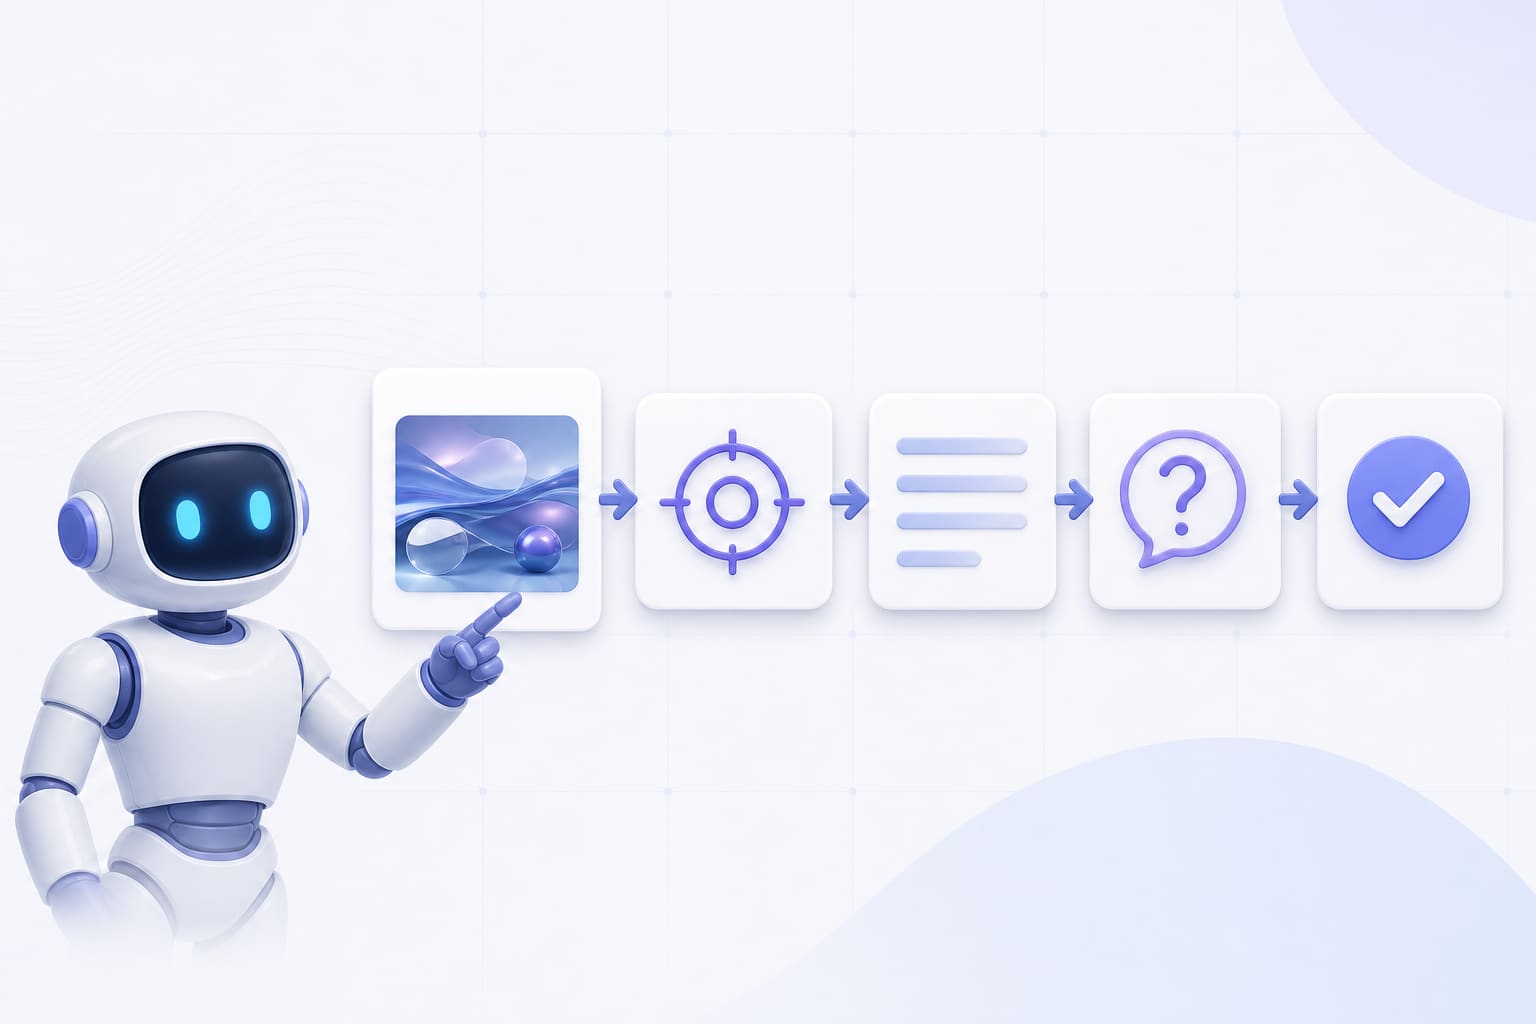
Пять шагов дают предсказуемый результат при любой модели: загрузить изображение, назвать цель текста, перечислить нужные элементы, задать формат ответа и проверить первый вариант уточняющим вопросом. Нейросеть онлайн бесплатный описание выдаёт быстрее, если инструкция не растянута на абзац, а разложена по этим пунктам.
Для alt-текста работает формулировка: «Опиши сцену одной нейтральной фразой до 125 знаков, назови главный объект и действие». Для карточки товара: «Укажи видимые характеристики, не придумывай бренд, материал и размер». Для соцсетей: «Сделай две подписи: нейтральную и эмоциональную». Для промпта генерации: «Разложи сцену на объект, композицию, свет, фон и стиль». Во всех четырёх случаях полезно добавить одну фразу, которая отделяет наблюдение от предположения: модель должна возвращать неизвестные значения как «не видно» вместо того, чтобы додумывать детали.
Удобнее всего работать в два прохода: сначала получить сухой список фактов — объекты, расположение, цвета, видимый текст, — а затем попросить адаптировать этот список под конкретную площадку. Такой порядок снижает риск того, что стиль подачи «съест» точность. Один универсальный промпт не заменяет этот процесс: формат результата меняется вместе с задачей, и то, что годится для архива, не подойдёт для карточки на маркетплейсе. Разница между моделями для разных сценариев разобрана на странице Как выбрать лучшую AI модель и не переплачивать. О пользе конкретной инструкции вместо общего «опиши это изображение» говорит и официальная рекомендация Google по точным запросам к изображениям.
Что выбрать для alt-текста, товаров, соцсетей и фотоархива
Для alt-текста важны краткость и нейтральность: описание передаёт главный смысл кадра без слова «фото» и без рекламных эпитетов, если они не несут смысловой нагрузки. Для карточки товара нужен перечень видимых свойств — цвет, форма, фактура — и прямой запрет на выдуманные размер, состав и бренд, которых на снимке не видно. Для соцсетей полезно получить несколько вариантов тона, сохранив при этом факты кадра без фантазийных деталей. Для фотоархива дата и место указываются только при наличии контекста в самом изображении или подписи к нему, а не по догадке модели.
Для разовой задачи удобен диалоговый сервис: загрузил фото, получил ответ, уточнил. Для массовых файлов логичнее API или пакетный режим, где один и тот же запрос применяется к серии кадров. Для сравнения качества между моделями подходит ModelStation с несколькими моделями в одном окне — там можно быстро понять, какая модель точнее распознаёт конкретный тип изображения нейросетью онлайн. Отдельно стоит проверять юридически чувствительные утверждения о товаре и личности: заявления о происхождении, качестве или возрасте человека на фото требуют подтверждения источником, а не уверенного тона ответа. Условия доступа к функциям сравнения описаны на странице Тариф — ModelStation. Коммерческий текст, который нейросеть написала за один проход, нельзя публиковать без сверки характеристик и требований конкретной площадки — черновик экономит время, но не заменяет редактора.
Как сравнивать ответы разных моделей и не переплачивать
Воспроизводимое сравнение строится на одинаковых условиях: одно и то же фото, одинаковый запрос, один язык и единый формат ответа. После этого модели оцениваются по пяти параметрам — полнота, фактическая точность, полезность для конкретной задачи, скорость ответа и стоимость. Длинный текст не равен лучшему результату: для alt-текста важнее точность и краткость, а для каталога товаров — стабильность структуры от карточки к карточке.
Единый интерфейс ModelStation снимает основную неудобную часть сравнения нейросетей для изображений: не нужно держать несколько вкладок и переключаться между аккаунтами, чтобы увидеть, какая модель точнее описала один и тот же кадр. Расходы тоже стоит считать заранее: бесплатный лимит хорош для теста на одном фото, но при серии файлов важны цена запроса, пакетная обработка и то, насколько стабильно модель повторяет формат на следующем кадре. Главная площадка проекта собрана на странице Все ТОП нейросети в одном пространстве.
При разборе ошибок полезны пять коротких критериев: пропущен ли главный объект, не перепутано ли действие, не выдумана ли характеристика, верно ли прочитан текст на кадре и не нарушен ли заданный тон. Возражение «достаточно выбрать самую известную модель» не работает на практике: качество ответа зависит от типа изображения и требований к выходному тексту куда сильнее, чем от известности бренда модели.
Ограничения, приватность и проверка готового результата
Нейросеть может ошибаться в лицах, мелких надписях, пространственных отношениях между объектами, количестве предметов, в медицинских кадрах и в сценах с неоднозначным контекстом. Для каждого риска есть конкретное действие: мелкий текст — увеличить фрагмент перед повторной загрузкой; сомнительное количество объектов — задать прямой уточняющий вопрос; смешение факта и догадки — попросить модель отделить видимое от предположительного; распознанный текст — сверить вручную с оригиналом; персональные данные на кадре — удалить перед отправкой или вовсе отказаться от загрузки чувствительного файла.
Правило публикации простое: сначала проверяются названия, числа, размеры, бренды, даты и любые обещания в тексте, и только потом результат адаптируется под конкретную площадку. Фраза «на фото виден красный предмет» — это наблюдение, которое можно публиковать сразу. Фраза «это дорогой кожаный товар» — уже вывод модели, который требует подтверждения материалом или описанием продавца. Фото объект онлайн нейросети распознают с разной надёжностью в зависимости от освещения, ракурса и качества съёмки, и уверенный тон ответа не говорит о точности: модель формулирует предположения так же гладко, как и факты. О возможностях и ограничениях распознавания подробно говорит документация Azure Image Analysis. История и принципы работы агрегатора изложены на странице О ModelStation. Дальше — практический разбор того, как довести фото от загрузки до готовой публикации, а затем ответы на частые вопросы читателей.
Практический сценарий: от загрузки фото до публикации результата
Берётся нейтральное фото товара на столе: кружка, упаковка с текстом на боку, фон без лишних предметов. Первый шаг — определить конечный формат: пусть это будет карточка для интернет-магазина. Второй шаг — загрузить изображение в выбранный сервис и задать точный запрос: «Перечисли видимые объекты, цвет, форму, материал и весь читаемый текст на упаковке. Не добавляй сведения, которых нет на изображении». Это описание изображения онлайн бесплатно нейросеть выдаёт за один проход, но останавливаться на нём рано.
Первый ответ даёт фактический список: цвет кружки, форма ручки, надпись на упаковке, фон стола. Второй проход превращает этот список в нужный формат — просьба «оформи это как карточку товара длиной три предложения» переводит факты в читаемый текст без изменения содержания. Уточняющий вопрос на этом этапе закрывает пробелы: если модель не распознала часть надписи, стоит прямо спросить, какие символы видны нечётко, а не принимать на веру целиком угаданную строку.
Удачный шаблон запроса стоит сохранить и применить к следующим похожим кадрам — это ускоряет серию похожих товаров, но каждый новый ответ всё равно проверяется отдельно, потому что ракурс, свет и упаковка на следующем фото неизбежно отличаются. Для регулярной работы с товарами удобен единый интерфейс со сравнением моделей в ModelStation, а для технической автоматизации десятков файлов — решения на основе API. Обзор бесплатных инструментов 2026 года собран в материале Бесплатные нейросети 2026: обзор сервисов. Пошаговый процесс кажется длиннее ручной работы только на первый взгляд: после настройки шаблона черновик собирается за минуту, а финальная проверка фактов остаётся обязательной в любом случае.
Как использовать ModelStation для сравнения AI-моделей
Платформа подходит читателю, которому нужен не один ответ, а возможность сравнить несколько моделей на одном фото и выбрать вариант под конкретную задачу. ModelStation объединяет AI-чаты, модели генерации и редактирования изображений, сравнение ответов, память контекста и оплату по факту использования в одном рабочем пространстве — без отдельной регистрации на каждый сервис и без набора разрозненных вкладок в браузере.
Сценарий простой: загружается один тестовый кадр, одинаковый запрос отправляется нескольким моделям, результаты сопоставляются по полноте и ошибкам, а затем выбирается наиболее точное описание. Удачный запрос сохраняется как шаблон и используется для следующих похожих изображений, что экономит время при серии однотипных задач. Подборка моделей для генерации изображений, которые можно сравнить таким же способом, собрана в материале Нейросеть для генерации изображений бесплатно: топ-10 сервисов.
Платформа особенно полезна создателям контента, специалистам по товарам, предпринимателям и тем, кто не хочет собирать десяток аккаунтов ради одной задачи с фото. Возражение «агрегатор нужен только профессионалам» не выдерживает критики: сравнение полезно даже для одной фотографии, если цена ошибки в карточке товара или подписи выше, чем несколько минут на проверку результата. Не все модели и функции доступны в одинаковом объёме на каждом тарифе — конкретные условия стоит смотреть в актуальном личном кабинете перед регулярной работой.
Какие форматы результата стоит сохранять для повторной работы
Практичный набор шаблонов закрывает большинство задач: краткое описание сцены, alt-текст, список объектов, OCR-блок с распознанным текстом, карточка товара, подпись для соцсетей и промпт для генерации. Для каждого формата действуют общие запреты: не добавлять факты, которых нет на кадре, сохранять язык исходного запроса, явно отмечать неизвестное как неизвестное и не смешивать OCR с интерпретацией сцены — распознанная строка текста и предположение о смысле надписи это разные вещи.
Главный объект этого раздела — описание изображений нейросетью, доведённое до формата, который можно использовать повторно. Сохранённый шаблон ускоряет пакетную обработку серии похожих кадров, но не отменяет выборочную проверку каждого файла: ракурс, освещение и состав сцены меняются от снимка к снимку, и ответ модели меняется вместе с ними. Понять, как описать изображение онлайн для своей конкретной задачи, проще всего на собственном примере — взять одно фото, пройти все пять шагов запроса и зафиксировать удачную формулировку.
Для одной задачи достаточно бесплатного диалогового инструмента с загрузкой изображения. Для регулярной работы нужен стабильный шаблон запроса и сравнение моделей между собой. Для бизнес-процесса с десятками файлов — структурированный доступ через API и контроль расходов. Материалы с разбором моделей, памяти и агентов собраны в разделе Понятно о моделях, памяти и агентах. Дальше — ответы на частые вопросы о бесплатности, приватности и точности таких инструментов.
Что проверить перед публикацией результата
Редакторский чек-лист перед публикацией включает шесть пунктов: совпадает ли главный объект с тем, что реально на кадре; не перепутано ли действие персонажа или предмета; подтверждаются ли упомянутые числа и надписи; нет ли выдуманных характеристик товара; подходит ли длина текста конкретной площадке; не раскрывает ли итоговый текст лишние персональные данные с фотографии. Финальная проверка обязательна даже тогда, когда ответ модели звучит уверенно и без оговорок — уверенный тон не признак точности.
Какие ошибки возникают при чтении текста на фото
Мелкий, размытый, наклонённый или частично закрытый текст — основная причина ошибок OCR. Рабочее правило: увеличить проблемный фрагмент отдельным кадром, попросить модель вывести распознанные строки отдельным списком и сверить каждую строку с оригиналом вручную. Буквальное распознавание символов и догадку о смысле надписи смешивать нельзя: модель может правильно прочитать часть слова и неверно додумать остальное, выдав это за один связный результат.
Как отличить факт на изображении от предположения модели
Надёжный маркер факта — формулировки «виден», «похоже на» и «не удаётся определить» вместо категоричных утверждений. Категоричные выводы о возрасте человека, его личности, цене предмета, качестве материала или стране происхождения товара без прямого подтверждения на кадре — зона повышенного риска: такие утверждения нейросеть формулирует так же уверенно, как проверенные факты, и это не делает их верными.
Короткий запрос для первого результата
Базовый шаблон для новой фотографии звучит так: «Опиши главный объект, его действие, фон, цвета и видимый текст, не добавляя догадок о том, чего не видно». Такого запроса достаточно, когда задача — получить общее представление о содержимом кадра. Когда нужен конкретный формат — alt-текст, карточка или подпись, — требуется уже специализированная формулировка с ограничением длины и тона.
Запрос для alt-текста и доступности
Для alt-текста полезно сразу ограничить длину ответа и попросить убрать декоративные детали, которые не помогают понять смысл изображения для пользователя с экранным диктором. Alt-текст не должен превращаться в набор ключевых слов или рекламный слоган: его задача — точно и коротко передать содержание кадра, а не продать товар ещё раз.
Запрос для карточки товара
Модель стоит прямо просить разделять видимые характеристики и неизвестные сведения: цвет, форма и материал указываются только при визуальном подтверждении на кадре, а размер, бренд, состав и комплектация не придумываются, если их не видно. Такое разделение экономит время на редактуре перед публикацией карточки.
Запрос для подписи в соцсетях
Полезно запросить сразу несколько вариантов подписи с разным тоном — нейтральный и эмоциональный, — сохранив при этом факты кадра без изменений. Выдуманные события, места и люди, которых нет в исходных данных, в подписи недопустимы, даже если они делают текст живее.
Как уточнять ответ без полной переработки запроса
Уточнение эффективнее, когда меняет один параметр за раз: сократить текст, добавить расположение объектов на кадре, перечислить цвета отдельным списком, выписать надписи отдельно от описания сцены, убрать предположения или перевести готовый результат на другой язык. Попытка переписать весь запрос заново обычно даёт менее предсказуемый результат, чем последовательная правка.
Проверка на одинаковом тестовом наборе
Мини-тест для сравнения моделей включает четыре типа кадров: одну предметную фотографию, один портрет без идентификации личности, одну сцену с видимым текстом и один сложный кадр с несколькими объектами. По каждому кадру оценивается полнота ответа, количество ошибок и то, пригоден ли результат для конечной задачи без серьёзной правки.
Стоимость и лимиты бесплатного доступа
Стоит различать три уровня доступа: бесплатный тест на одном файле, бесплатный тариф с ограничением по числу запросов и платную автоматизацию для серийной обработки. Фиксированные лимиты на будущее обещать нельзя — условия меняются у каждого сервиса по-своему. Для регулярной обработки важнее сравнить цену одного запроса, скорость ответа и стабильность формата от файла к файлу, чем ориентироваться на разовый бесплатный лимит.
Когда нужен API и пакетная обработка
Профессиональный сценарий узнаётся по нескольким признакам: десятки или сотни файлов для обработки, требование единого формата ответа, интеграция с каталогом, CMS или архивом, необходимость журналирования запросов и контроля расходов. Для одной фотографии такая инфраструктура избыточна — диалогового сервиса достаточно.
Приватность личных и рабочих фотографий
Перед загрузкой стоит удалить с кадра лишние лица и документы, не передавать коммерческие материалы компании без разрешения, изучить условия обработки данных конкретного сервиса и хранить итоговый результат отдельно от исходного файла. Это снижает риск случайной утечки чувствительных данных вместе с фотографией.
Особенности анализа медицинских и чувствительных сцен
Описание изображения нейросетью не является медицинской или экспертной диагностикой ни при каких условиях. Для снимков с медицинским или юридически значимым содержанием нейросеть используется только как вспомогательный инструмент для предварительной сортировки материалов, а финальное заключение остаётся за специалистом.