Почему в 2026 году нельзя выбирать нейросеть только по названию
Пользователь открывает список и видит десятки знакомых и незнакомых названий, но не понимает, где заканчивается модель и начинается сервис, тариф или просто оболочка поверх чужого API. Один и тот же провайдер часто предлагает сразу несколько режимов одной линейки: быстрый для коротких ответов, рассуждающий для сложных задач, мультимодальный для работы с файлами и изображениями, агентный для многошаговых процессов и специализированный — под код или перевод. Выбор названия без понимания режима почти всегда приводит к разочарованию.
Бытовой пример показывает разницу наглядно. Для письма клиенту достаточно быстрой модели с коротким ответом за секунды. Для анализа договора на десять страниц нужен длинный контекст и устойчивость к противоречивым пунктам. Для рекламного ролика важны уже не текстовые параметры, а стабильность кадра и контроль движения камеры. «Самая мощная» модели нейросетей 2026 года в одном сценарии проигрывает дешёвой и быстрой — в другом.
Далее в статье применяются девять критериев: качество результата на конкретной задаче, уровень владения русским языком, длина контекста, список поддерживаемых файлов, скорость ответа, условия приватности, фактическая доступность в России, лимиты использования и цена за объём. Каталог, который просто называет единственного победителя, вводит в заблуждение: лидер меняется в зависимости от задачи, бюджета и региона пользователя. Редакция сознательно не даёт один финальный ответ — вместо этого показывает логику выбора, которую можно применить самостоятельно уже сегодня, опираясь на каталог моделей Gemini API, где заметно, что даже один провайдер держит параллельно несколько разных по назначению моделей.
Этот подход переводит читателя из состояния «выбрать по шуму в ленте» в состояние «сравнить по параметрам своей задачи». Дальше статья разбирает классы моделей, конкретные решения для текста, кода, изображений, видео и музыки, а также агрегатор ModelStation как вариант, когда нужно протестировать несколько ai модели без регистрации в каждом отдельном сервисе. Материалы по теме собраны в разделе «Понятно о моделях, памяти и агентах».
Какие бывают AI-модели: текст, мультимодальность, генерация и агенты
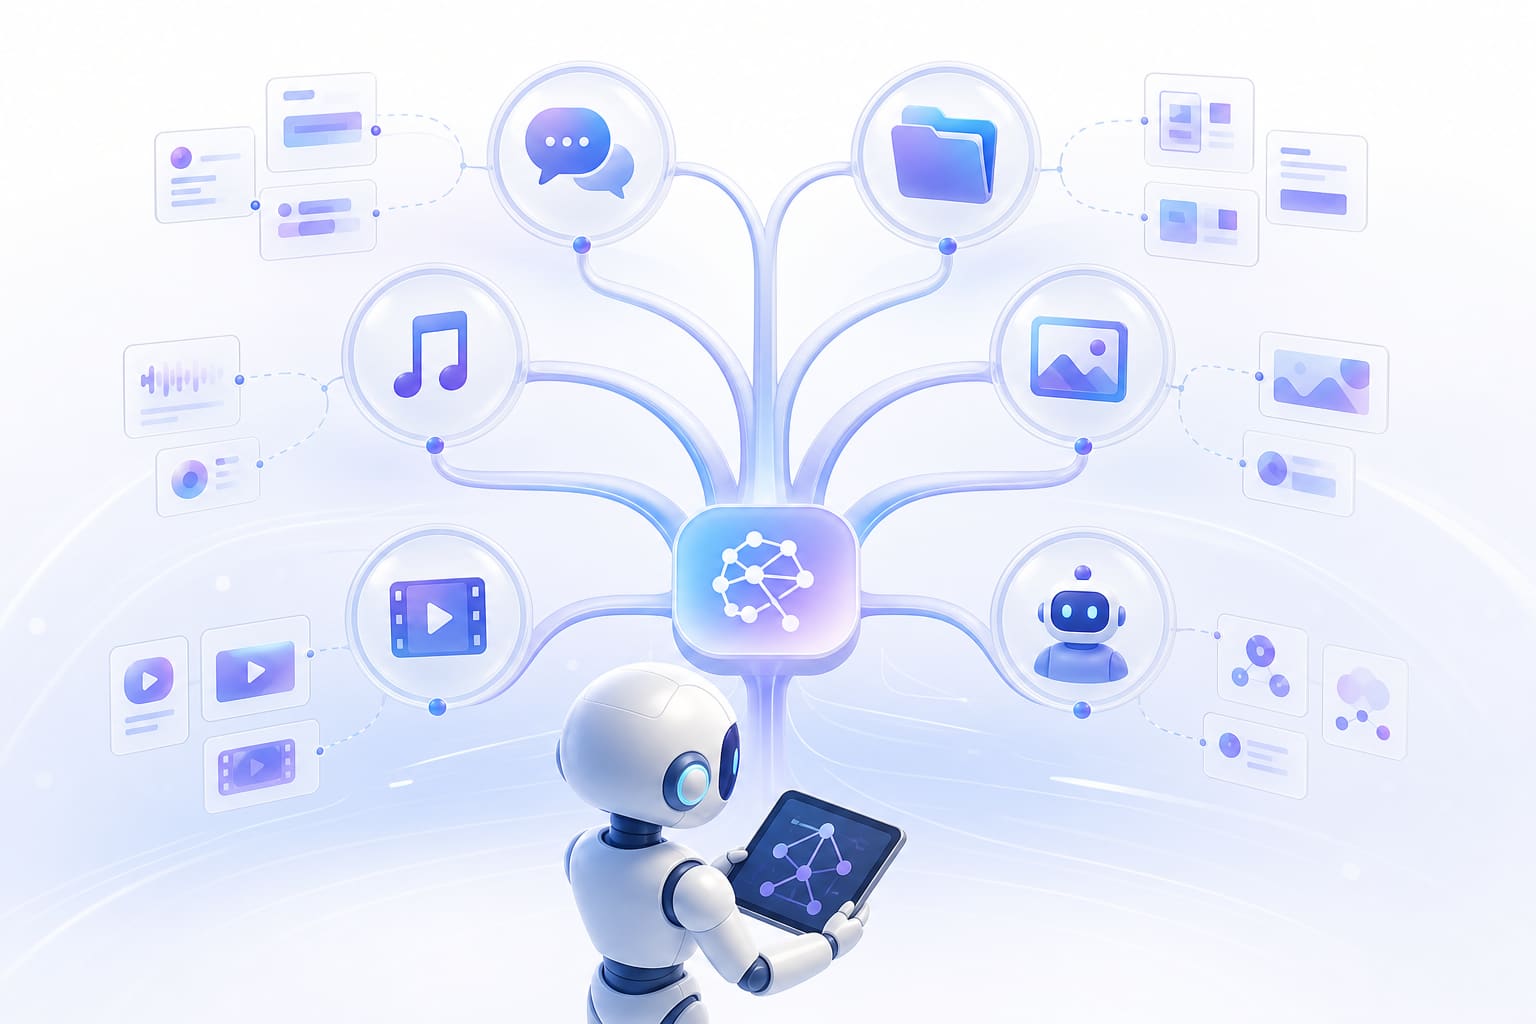
Рынок делится на понятные классы, и смешивать их в одну кучу — главная причина путаницы при выборе. Текстовые языковые модели ведут диалог, делают суммаризацию длинных материалов, переводят, классифицируют обращения и выполняют инструкции по шаблону: ответить клиенту, сократить отчёт, переписать абзац другим тоном. Это базовый класс, с которого начинают почти все пользователи.
Мультимодальные модели принимают не только текст, но и изображения, PDF, таблицы Excel, аудио или видео одновременно в одном запросе. Пользователь может загрузить скан счёта и попросить вытащить сумму и дату, или прикрепить график продаж и спросить про аномалии. Такие модели нейросетей 2026 года закрывают задачи, где раньше требовалось отдельное OCR-приложение плюс чат.
Отдельный класс — генеративные модели изображений, видео, музыки и речи. У них другие критерии оценки: точность факта почти не применима, зато важны композиция, стабильность персонажа, естественность голоса и соответствие референсу. Оценивать картинку по тем же меркам, что текст, бессмысленно — там работает визуальное восприятие, а не проверка цитат.
Agent отличается от обычного чата структурно: ему задают роль, набор инструкций, доступные инструменты и память о предыдущих шагах, после чего он самостоятельно разбивает задачу на этапы, собирает данные и готовит черновик. Разница ощутима на практике: чат отвечает один раз на один запрос, агент может сходить в несколько источников, сверить цифры и вернуться с подготовленным файлом — но именно поэтому ему нужен контроль доступа и проверка каждого шага, а не слепое доверие.
Практическая мини-схема работает так: пользователь сначала формулирует конечный результат, затем выбирает тип результата — текст, изображение, видео, музыка или автоматизированный процесс, — и только после этого подбирает конкретную модель и интерфейс под эту связку. Запрос «все ии нейросети» в поиске не имеет конечного списка: рынок меняется еженедельно, одно название может означать целое семейство моделей, а другое — узкую версию с конкретным номером. Подробнее о работе с ролями и инструментами собрано в разделе AI-агенты ModelStation, а механика связанных вызовов описана в документации по агентным взаимодействиям Gemini. Один универсальный чат не заменяет весь рынок — он закрывает только текстовый сегмент.
Лучшие текстовые модели для письма, анализа документов и русского языка
Сравнение текстовых моделей имеет смысл строить не по абстрактному рейтингу, а по рабочей задаче. GPT-линейка хорошо держит структуру длинного ответа и логическую цепочку рассуждений, поэтому подходит для технического задания или многошагового плана. Claude заметно аккуратнее работает с большими документами и сохраняет нюансы длинного текста при редактуре, не теряя исходный тон автора. Gemini силён там, где в одном запросе нужно смешать текст, таблицу и изображение. DeepSeek и Qwen предлагают выгодное соотношение цены и качества на объёмных деловых текстах и неплохо держат несколько языков одновременно. GigaChat и YandexGPT — российские модели нейросетей 2026 года, которые ближе к разговорной норме русского языка и локальным реалиям, но по глубине сложного рассуждения иногда уступают топовым зарубежным решениям.
Для короткого письма клиенту выгоднее быстрая и недорогая модель: задержка в секунду и минимальная стоимость токена важнее абсолютной глубины анализа. Для договора или исследовательского отчёта важнее контекст в десятки тысяч токенов и устойчивость к противоречивым вводным — модель не должна «забывать» условие из середины документа к финалу ответа.
Ограничение общее для всех текстовых моделей: они могут уверенно ошибаться, путать похожие факты, сокращать важные детали при пересказе и неверно трактовать сложную таблицу с объединёнными ячейками. Проверка обязательна там, где цена ошибки высокая.
Два рабочих примера промпта. Для редактора: «Сократи текст до 1200 знаков, сохрани все цифры и имена, убери канцелярит, не меняй порядок аргументов». Для аналитика: «Сравни три квартала по таблице, выдели аномалии больше 15% и укажи, на какой строке таблицы основан каждый вывод». Критерий проверки ответа один: сверить каждую цифру и факт с исходником вручную, а не оценивать ответ по красоте формулировки. Дорогая модель не пишет автоматически лучше человека — она экономит время на черновике, но финальную ответственность редактор оставляет на себе. Подробный разбор «все модели нейросетей» для текста собран в материале «Нейросети для текста: рейтинг 10 генераторов онлайн», а практику выбора под задачу раскрывает статья «Как выбрать лучшую AI модель и не переплачивать». Официальные условия тарификации можно свериться по странице цен OpenAI API и API Claude от Anthropic.
Нейросети для кода, исследований и работы с актуальными данными
Код и исследовательские задачи требуют не красивого ответа, а способности работать с файлами, вызывать инструменты, искать в сети и проверять многошаговую логику. Чат с сильным рассуждением хорошо объясняет алгоритм и пишет первую версию функции. Специализированный кодовый режим точнее держит синтаксис конкретного языка и реже путает устаревшие библиотеки. Агент, который вызывает инструменты, может сам запустить линтер или собрать зависимости. Поисковый сервис с указанием источников нужен там, где важна не генерация текста, а подтверждённый факт со ссылкой.
Типовые сценарии распределяются так: исправление конкретной ошибки по стек-трейсу, написание новой функции по спецификации, ревью pull request с комментариями по стилю и безопасности, составление технического задания для подрядчика, поиск свежих сведений по теме и сводка по нескольким источникам одновременно. Для каждого сценария нужен свой баланс между скоростью и глубиной.
Актуальность ответа подтверждается только ссылками на источники, а не самим фактом ответа модели. Код проверяется запуском тестов, статическим анализом и отдельной проверкой безопасности зависимостей — ни один из этих шагов не заменяется доверием к генерации. Модель может предложить устаревший метод API, подключить небезопасную библиотеку, сослаться на несуществующую функцию или допустить логическую ошибку в расчёте граничного условия — такие случаи встречаются регулярно и требуют человеческой проверки перед продакшеном.
Бесплатного режима достаточно для рутинных однострочных правок и простых скриптов без внешних зависимостей. Расширенный контекст и вызов инструментов нужны там, где модель должна держать в памяти всю кодовую базу проекта или самостоятельно обращаться к документации API во время работы. Список доступных способов вызова моделей, включая потоковые и интерактивные режимы, описан в официальном справочнике Gemini API, а сводный разбор инструментов для разных сценариев собран в материале «Какие нейросети лучшие для текста, генерации фото, видео и музыки».
Модели для генерации изображений и редактирования фотографий
Визуальные инструменты удобнее разбирать по результату, а не по популярности бренда. Генерация с нуля создаёт изображение по текстовому описанию без исходника. Редактирование исходного фото меняет конкретный элемент на готовой картинке — фон, цвет, объект. Замена фона и сохранение персонажа решают разные задачи: первая просто меняет окружение, вторая требует удержать черты лица и позу на новом изображении. Стилизация адаптирует существующий кадр под другую эстетику, а создание серии изображений держит единый стиль между несколькими карточками для рекламной кампании.
Качество картинки зависит не от магии модели, а от точности описания, качества референса, контроля композиции, количества сгенерированных вариантов и способности модели удерживать мелкие детали — текст на упаковке, количество пальцев, форму логотипа. Текст-в-изображение подходит для черновой идеи с нуля, image-to-image — когда нужно сохранить композицию исходника, а локальное редактирование — когда меняется только один элемент без пересборки всей сцены.
Рабочий сценарий для контент-специалиста выглядит так: исходное фото товара, задача «показать товар в интерьере», ограничение бренда по цветовой палитре, три-четыре итерации с правками по композиции и финальная проверка рук, читаемого текста на упаковке, логотипа и лиц людей на фоне — именно эти элементы чаще всего ломаются у всех ии нейросети без исключения.
Отдельный момент — права на исходные материалы. Загрузка чужой фотографии без разрешения, изображение узнаваемого человека без согласия и коммерческое использование готового макета требуют отдельной проверки условий конкретного сервиса — одной общей нормы для всего рынка не существует. Генератор не создаёт готовый рекламный макет с первого запроса: обычно нужно три-пять итераций, правка композиции и ручная доводка мелких деталей в редакторе. Примеры рабочих сценариев собраны в разделе «Изображения, которые работают на вашу идею», а пошаговая инструкция — в материале «Как использовать нейросети для генерации фото и картинок». Цена генерации изображения у разных провайдеров отличается в разы, поэтому тестовый прогон перед массовой закупкой всегда дешевле, чем переделка готовой партии. Официальный список визуальных моделей опубликован в документации Google.
AI-видео: генерация сцен, оживление фото и монтажные задачи
Видео-модели решают несколько разных задач, и путать их между собой — частая ошибка. Text-to-video создаёт ролик по описанию с нуля, image-to-video оживляет статичную фотографию, продолжение ролика добавляет кадры к уже существующему клипу, изменение фона заменяет окружение без пересъёмки, а управление движением камеры задаёт плавный наезд или панораму поверх исходной сцены.
Сравнивать стоит по восьми параметрам: стабильность персонажа между кадрами, физика движения объектов, синхронизация звука с губами или действием, длительность клипа, итоговое разрешение, контроль первого и последнего кадра, скорость рендеринга и расход генераций на один удачный результат. Сравнение AI инструментов цена здесь особенно заметно: за один связный ролик в десять секунд часто приходится оплатить пять-семь попыток, а не одну.
Пример для малого бизнеса: из фотографии товара собирается короткий ролик на пять-восемь секунд с лёгким вращением камеры. После генерации нужно проверить форму предмета на искажение, читаемость надписей на упаковке, естественность рук, если в кадре есть человек, и плавность движения камеры — рывки и «плывущий» фон выдают генерацию сразу.
Длинный фильм почти всегда строится из отдельных сцен по десять-пятнадцать секунд, а не генерируется одним запросом: современные модели нейросетей 2026 года ограничены по длительности единичного клипа, и склейка сцен в монтажёре остаётся обязательным этапом. Видео-модель не заменяет монтажёра целиком: сценарий, раскадровка, финальный монтаж, подбор звука и юридическая проверка прав на музыку и изображения людей остаются отдельными шагами вне генерации. Примеры сценариев и разбор инструментов собраны в материале «Как использовать нейросети для создания ИИ-видео», а перечень актуальных моделей — в официальном списке видеомоделей Google.
Музыкальные модели и генерация песен: от идеи до готового трека
Музыкальное направление — отдельный класс AI-инструментов со своей логикой запроса. Пользователь задаёт жанр, настроение, темп, назначение трека — фон для видео, джингл для рекламы или полноценная песня — а также выбирает вокал, дуэт или чисто инструментальную композицию. Результатом становится черновик, который либо готов к использованию, либо требует доработки в редакторе.
Генерация мелодии, текста песни, вокала и полного трека — разные операции внутри одного сервиса. Можно получить только инструментал под видео, только текст куплета для дальнейшей записи живым голосом или сразу готовую композицию со всеми слоями одновременно — выбор зависит от того, что именно нужно на выходе.
Практический сценарий: идея ночной поездки по городу, короткое описание настроения — «спокойный синти-поп, огни города, лёгкая меланхолия» — выбор жанра, три-четыре сгенерированных варианта, проверка структуры куплет-припев-куплет и сверка условий лицензии перед публикацией. Все модели нейросетей 2026 года в этом сегменте иногда повторяют узнаваемые мелодические приёмы, могут ошибаться в произношении редких слов, терять структуру на длинной композиции и выдавать результат, который требует ручного монтажа перед релизом.
Вопрос авторских прав требует осторожности: условия зависят от конкретного сервиса, выбранного тарифа и типа итогового результата, поэтому нельзя обещать одинаковые права на все платформы — перед коммерческим использованием трека условия нужно сверять по актуальной оферте конкретного сервиса. Генератор песни не гарантирует коммерческий хит: он даёт быстрый черновик и несколько вариантов звучания, а итоговое попадание в аудиторию по-прежнему зависит от сведения, аранжировки и продвижения. Сценарии создания трека описаны в разделе «Музыка/Песни», а пошаговый разбор — в материале «Генерация музыки и песен с помощью искусственного интеллекта», где показана механика выбора жанра, стиля, настроения и голоса. Цена генерации одного трека обычно ниже, чем аренда студии на час, что делает черновой вариант доступным для теста идеи до вложений в полноценную запись.
AI-агенты и автоматизация: когда чата уже недостаточно
Агент отличается от обычного диалога тем, что получает не один вопрос, а роль, инструкции, доступные инструменты, контекст задачи и критерии готового результата. Для предпринимателя, редактора, аналитика и специалиста поддержки это важно практически: вместо отдельного запроса на каждый шаг агент сам разбивает задачу на этапы, собирает нужные данные и готовит черновик для финальной проверки человеком.
Четыре рабочих сценария показывают разницу с чатом наглядно. Разбор договора: агент выделяет риски по пунктам и указывает, на какой строке основан каждый вывод. Ответ клиенту: агент читает историю переписки и готовит черновик письма с учётом тона предыдущих сообщений. Подготовка отчёта: агент собирает данные из нескольких файлов и формирует единую сводку с источниками каждой цифры. Создание промпта для видео или изображения: агент помогает сформулировать точное описание сцены с нужными параметрами камеры и композиции.
Границы безопасности здесь принципиальны: как выбрать нейросеть 2026 для автоматизации — вопрос не только удобства, но и контроля. Агенту нельзя без подтверждения человека выдавать доступ к платежам, удалению данных, публикации готовых материалов и любым юридически значимым действиям — ошибка на этом уровне обходится значительно дороже, чем неудачный черновик текста.
Хороший агент не обещает абсолютную автономность, а объясняет, на каком источнике основан каждый вывод, и прямо указывает момент, где решение должен принять человек. Это не просто красивое название для чата: разница в архитектуре — память, инструменты и многошаговый план — определяет, какие задачи вообще можно доверить системе без постоянного присутствия оператора. Официальное описание механики связанных взаимодействий моделей и инструментов приведено в материале Google по агентным сценариям, а общий обзор подхода ModelStation к агентам — на странице «О ModelStation».
Сравнительная таблица моделей 2026 года по задачам и стоимости
Прямое сравнение тарифов разных провайдеров требует держать в уме сразу несколько переменных: отдельная цена за токен на входе и выходе, отдельная тарификация изображений и видео, скидка при кэшировании повторяющегося контекста, пакетные режимы для массовой обработки и комиссии платёжных систем при оплате из России. Сводная таблица ниже помогает быстро сузить список кандидатов на основе открытых прайс-листов и каталога ModelStation, но не заменяет проверку актуальных цифр перед запуском проекта.
| Модель и провайдер | Сильный сценарий | Ввод, USD | Вывод, USD | Практическое ограничение |
|---|---|---|---|---|
| GPT-5.6 Sol, OpenAI | Сложный анализ, документы, рассуждение | 0,0125 | 0,075 | Высокая стоимость при больших объёмах |
| Claude Opus 5, Anthropic | Длинные документы и нюансная редактура | 0,0125 | 0,0625 | Нужна проверка фактов и лимитов доступа |
| Gemini 3.1 Pro Preview, Google | Мультимодальные задачи и большие материалы | 0,005 | 0,03 | Preview-режим может меняться |
| Qwen 3.8 Max, Alibaba | Длинные тексты, деловые задачи, несколько языков | 0,005 | 0,015 | Качество зависит от сценария и интерфейса |
| Grok 4.5, xAI | Живой тон и работа с актуальными темами | 0,005 | 0,015 | Актуальность ответа требует проверки источников |
| Kimi K3, Kimi | Код, интерфейсы и многошаговые задачи | 0,0025 | 0,0075 | Не каждый сценарий требует такого режима |
Из таблицы следует три практических вывода. Дорогая модель нужна не всегда — для короткого делового письма переплата за топовый тариф не окупается качеством результата. Дешёвая модель может быть выгоднее именно на массовых коротких операциях вроде классификации обращений, где счёт идёт на тысячи запросов в день. Агрегатор удобен, когда нужно протестировать сравнение AI инструментов цена сразу у нескольких провайдеров без оформления отдельной подписки под каждый. Таблица не заменяет тестирование на реальной задаче: цены меняются, а итоговое качество ответа всё равно проверяется на конкретном промпте и конкретном файле пользователя. Официальные прайсы можно свериться по странице OpenAI API, Claude API и каталогу моделей Gemini.
Как выбрать нейросеть 2026 под задачу: пошаговый алгоритм
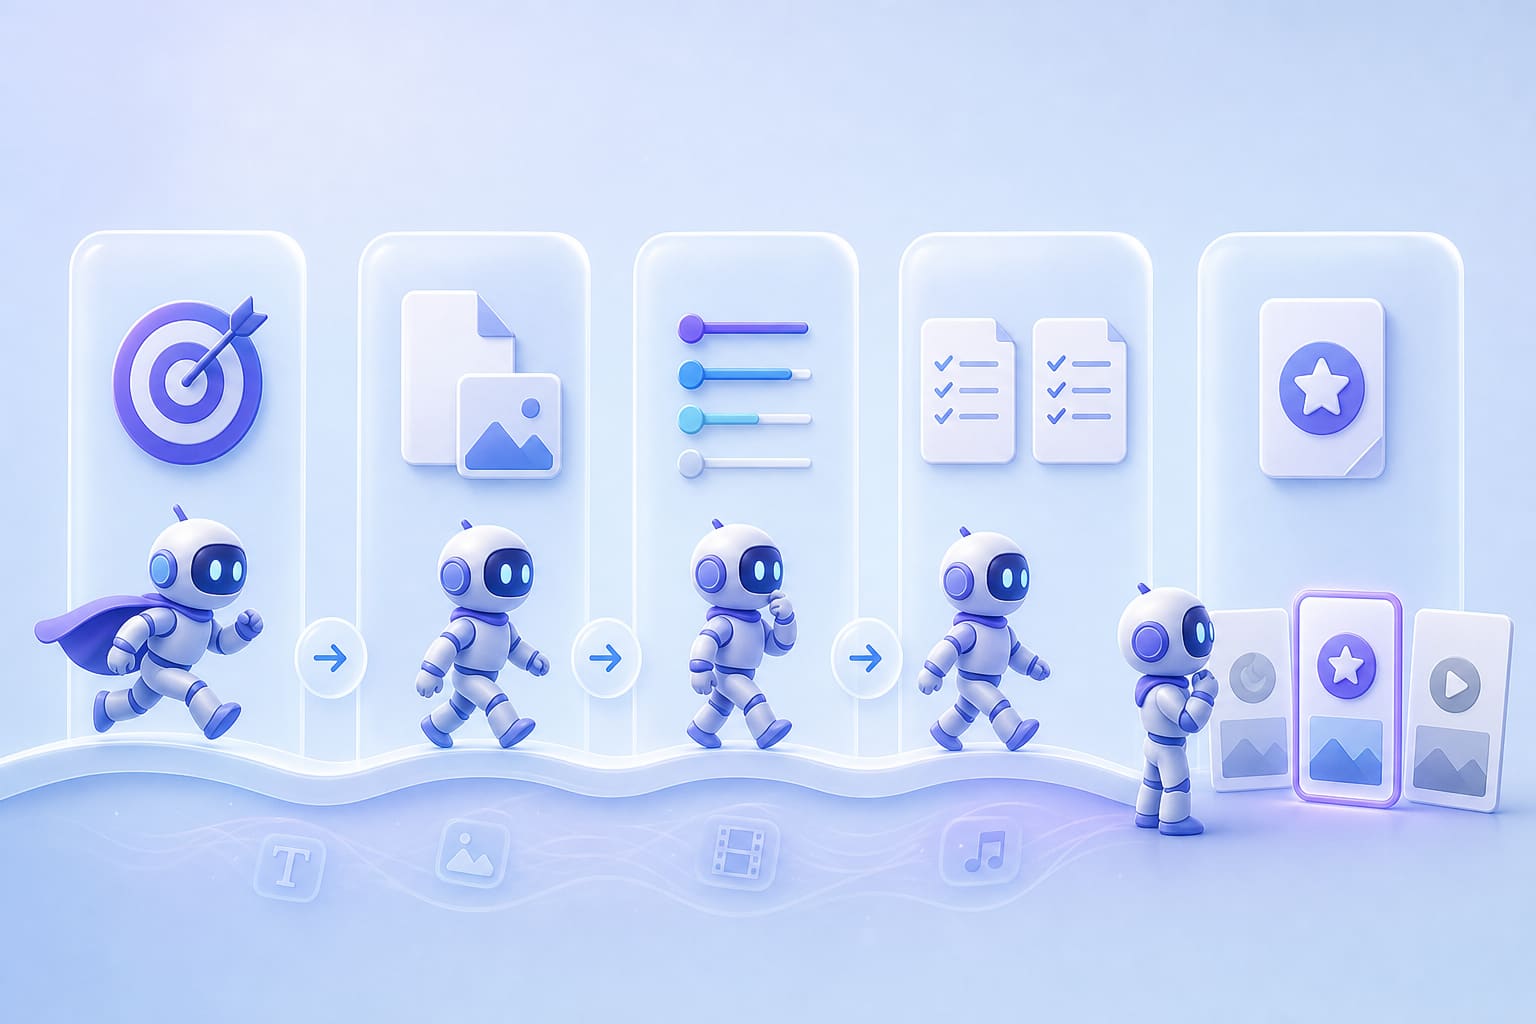
Алгоритм ниже применяется до регистрации и до оплаты, на основе одного только описания задачи.
Шесть шагов выбора
Шаг 1 — описать конечный результат: письмо, отчёт, код, изображение, ролик, песня или автоматизированный процесс. Шаг 2 — определить входные данные: только текст, файлы, изображения, аудио, видео или внешние источники для проверки фактов. Шаг 3 — выбрать главный приоритет: качество, скорость, приватность, русский язык, контроль формата или минимальная стоимость — приоритетов может быть несколько, но один всегда главный. Шаг 4 — оценить объём и частоту запросов, чтобы понять, что выгоднее: подписка, API или оплата по факту. Шаг 5 — провести короткий тест на одном и том же промпте в двух-трёх моделях и оценить не красоту формулировки, а пригодность результата для конкретной задачи. Шаг 6 — проверить лимиты, фактическую доступность, возможность экспорта результата, условия лицензии и возможность отмены подписки без лишних шагов.
Матрица решений для четырёх типов пользователей
Новичку подходит бесплатный или недорогой тариф с быстрой моделью и простым интерфейсом без настройки API. Автору контента нужна связка из текстовой, визуальной и видео-модели в одном месте, чтобы не переключаться между пятью вкладками. Предпринимателю важны приватность, стабильная доступность и возможность работать с документами компании. Разработчику нужен прямой доступ к API, расширенный контекст и вызов инструментов для встраивания модели в продукт.
Для выбора не обязательно тестировать весь рынок: достаточно сравнить двух-трёх кандидатов на своей реальной задаче, а не на абстрактном рейтинге из статьи. Подробный разбор критериев собран в материале «Все про нейросети: как выбрать ИИ-инструмент онлайн», а назначения конкретных моделей можно свериться по официальному описанию сценариев Gemini.
Доступность в России, приватность и локальные ограничения
Для пользователей из Москвы, Санкт-Петербурга и других регионов России доступность складывается не из одного фактора, а из нескольких одновременно: открывается ли сайт сервиса без дополнительных настроек, принимается ли оплата российской картой или требуется посредник, доступен ли API напрямую, есть ли русская локализация интерфейса, можно ли экспортировать готовый результат в нужном формате и как именно сервис обрабатывает загруженные пользователем данные.
Личный и корпоративный сценарии требуют разного уровня осторожности. Для личного черновика письма допустим один уровень риска — ошибка обойдётся недорого. Для договора, клиентской базы или внутреннего отчёта компании риск выше на порядок, поэтому решение о том, какой сервис использовать, принимается отдельно для каждого типа данных.
Чек-лист приватности из пяти пунктов снижает риск независимо от выбранной модели: не загружать персональные данные сверх минимально необходимых, удалять идентификаторы клиентов перед отправкой в чат, проверять условия хранения загруженных файлов у конкретного сервиса, ограничивать доступ агентам к чувствительным системам и обязательно сохранять финальные версии документов локально, а не полагаться только на историю чата.
Российская модель не автоматически безопаснее зарубежной, а зарубежная не всегда недоступна технически — условия меняются регулярно в обе стороны, поэтому решение принимается по конкретному сервису и конкретному способу работы, а не по общему правилу «все ии нейросети одной страны лучше других». Техническая доступность — то, что сайт открывается и принимает оплату, — не равна юридической и организационной пригодности для работы с чувствительными данными компании: это два разных вопроса, и смешивать их опасно. Условия доступа к API можно свериться по официальной странице Anthropic.
Как контролировать расходы: подписка, API или единый баланс
Три финансовые модели закрывают разные сценарии использования. Подписка удобна, если пользователь регулярно работает в одном сервисе и укладывается во включённые лимиты запросов — переплата возникает только при систематическом превышении этих лимитов. API подходит разработчику, который встраивает модель в собственный продукт и готов считать входные и выходные токены отдельно, а также учитывать расходы на хранение контекста, кэширование повторяющихся запросов и подключение дополнительных инструментов. Оплата по факту использования удобна для нерегулярных задач, тестирования разных провайдеров и разовых креативных экспериментов без обязательств на месяц вперёд.
Скрытые расходы редко считают заранее: несколько параллельных подписок под разные задачи, платные функции экспорта в нужном формате, оплата за каждый дополнительный вариант генерации, перерасход контекста на длинных документах, отдельная тарификация изображений и видео, комиссии платёжных систем и время сотрудника на переключение между разными кабинетами — последнее редко попадает в бюджет, но реально съедает часы работы в месяц.
Простая формула бюджета помогает оценить расход заранее: частота запросов в месяц умножается на средний объём входа и выхода в токенах или минутах, затем на тариф конкретной модели, и к результату прибавляются дополнительные операции вроде генерации нескольких вариантов изображения. Единый баланс в ModelStation может быть понятнее именно при тестировании нескольких моделей одновременно, потому что весь расход виден в одном месте, а не распределён по пяти разным выпискам — но это не гарантирует автоматически минимальную сумму для любого сценария, экономия зависит от того, какие именно модели и в каком объёме используются. Месячный лимит ставится заранее на этапе подключения оплаты, после чего результат сравнивается на одинаковом объёме работы между разными моделями — только так видно, какой вариант реально выгоднее, а не кажется таким на первый взгляд. Тарифная логика API подробно описана в документации OpenAI и в условиях оплаты Claude API.
Зачем нужен агрегатор AI-моделей и когда он действительно выгоден
Агрегатор — это рабочий слой между пользователем и несколькими провайдерами, а не волшебная замена каждому отдельному инструменту. Практические преимущества такого слоя конкретны: один аккаунт вместо десяти, единый баланс вместо пяти разных счетов, возможность сравнить ответы нескольких ai модели на одном и том же промпте, память контекста, которая сохраняется между сессиями, подбор подходящей модели под конкретную задачу и доступ к тексту, изображениям, видео, музыке и агентам в одном интерфейсе без переключения вкладок.
Два сценария показывают, когда агрегатор уместен, а когда нет. В первом пользователь каждый день работает с одной и той же моделью для одной и той же задачи — здесь прямой сервис провайдера часто удобнее, потому что интерфейс заточен под эту конкретную модель. Во втором пользователь тестирует разные варианты, создаёт контент в разных форматах, решает задачи нерегулярно и хочет платить только за фактическое использование — здесь агрегатор снижает трение: не нужно заводить отдельный аккаунт под каждый новый эксперимент.
Ограничения агрегатора честно стоит назвать сразу. Работа зависит от доступности самого провайдера — если у него сбой, недоступна и функция внутри агрегатора. Интерфейс может отличаться от оригинального кабинета провайдера некоторыми деталями управления. Условия лицензии и цену конкретного типа генерации — особенно для видео и музыки — всё равно нужно проверять отдельно для каждого результата, который планируется использовать коммерчески. Единое окно не гарантирует лучший результат без настройки: модель всё равно нужно выбрать осознанно под задачу, а не рассчитывать, что любой запрос в любой модели даст одинаково хороший ответ. Полный список доступных моделей показывает, насколько разнообразен рынок уже сейчас — он опубликован в официальном каталоге Google.
Практические связки моделей для автора, бизнеса и команды
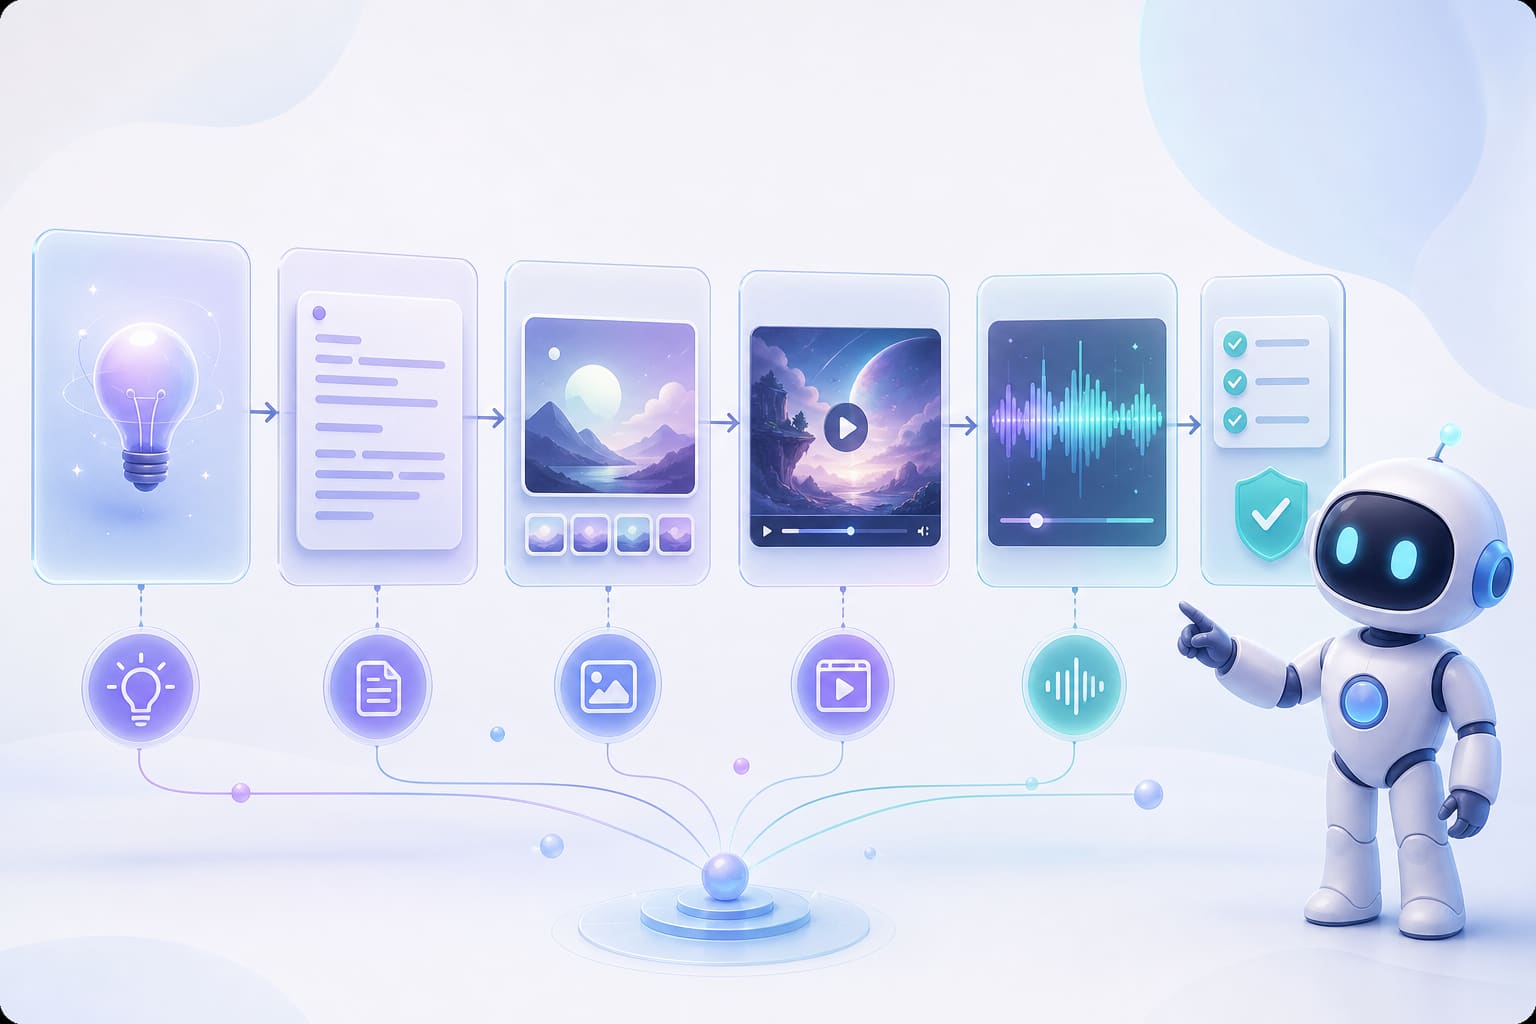
Вместо единого рейтинга полезнее собрать несколько готовых архитектур работы под конкретные роли. Для автора контента связка выглядит так: текстовая модель готовит идею и структуру материала, визуальная модель создаёт обложку по этой структуре, видео-модель собирает короткий ролик-анонс, музыкальная модель подбирает фоновую дорожку, а финальную проверку всех элементов делает редактор-человек перед публикацией.
Для предпринимателя цепочка другая: сначала анализ входящих документов, затем AI-агент классифицирует обращение по типу и срочности, текстовая модель готовит черновик ответа клиенту, а финальное утверждение остаётся за человеком перед отправкой. Для маркетолога: исследование темы, несколько вариантов текста для A/B-теста, генерация визуала под каждый вариант, адаптация под разные форматы публикации и обязательный ручной контроль фактов перед выходом в эфир. Для разработчика: быстрая и недорогая модель закрывает рутинный код, сильная модель с длинным контекстом нужна для архитектурных решений, а отдельный агент проводит ревью pull request перед слиянием в основную ветку.
Связка моделей часто оказывается дешевле и надёжнее, чем постоянное использование самой дорогой модели нейросетей 2026 года на каждом шаге подряд: рутинную часть закрывает недорогой вариант, а дорогой ресурс тратится только там, где действительно нужна глубина. Важная деталь, о которой часто забывают: на каждом переходе между этапами нужно явно передавать исходные ограничения — бренд-гайд, тон коммуникации, формат файла — иначе следующая модель в цепочке потеряет контекст и выдаст результат, не совпадающий с предыдущим шагом. Один универсальный инструмент редко решает всю цепочку одинаково хорошо: специализация на каждом шаге обычно даёт более стабильный итоговый результат, чем попытка закрыть всё одной моделью. Механика связанных многошаговых сценариев с моделями и агентами описана в материале Google по агентным взаимодействиям.
Типичные ошибки при выборе и использовании нейросетей
Семь ошибок встречаются регулярно и приводят к лишним расходам или слабому результату. Первая — выбор по громкому названию вместо реальной задачи: исправление — заранее сформулировать результат и критерии его проверки до того, как открывать список моделей. Вторая — сравнение ответов на разных промптах и с разными входными файлами, из-за чего вывод о «лучшей» модели оказывается некорректным: исправление — единый тестовый промпт и один и тот же файл для всех кандидатов.
Третья ошибка — оценка только первой красивой генерации без проверки фактов, авторских прав и стабильности при повторном запуске: исправление — короткий чек-лист проверки перед использованием результата в работе. Четвёртая — оплата нескольких подписок до расчёта реальной частоты использования: исправление — сначала посчитать объём задач за месяц, потом выбирать тарифную модель.
Пятая ошибка — загрузка конфиденциальных данных без минимизации и контроля хранения: исправление — обезличивание данных перед отправкой в любую модель. Шестая — попытка поручить агенту необратимое действие без подтверждения человека: исправление — обязательное ручное утверждение на критичных шагах вроде платежей или публикации. Седьмая — ожидание, что модель знает свежие сведения без поиска и ссылок на источники: исправление — проверка актуальности через отдельный поисковый инструмент, а не через доверие к памяти модели.
Эти ошибки возникают не только у новичков: опытные пользователи так же часто торопятся с выводом после одной генерации или недооценивают суммарную стоимость нескольких параллельных подписок — разница лишь в том, что опытный пользователь быстрее замечает проблему и корректирует процесс. Обзор бесплатных вариантов для старта без финансового риска собран в материале «Бесплатные нейросети 2026: обзор сервисов», а параметры, влияющие на итоговую стоимость запроса, можно свериться по официальной странице тарифов API.
Итог
Рынок моделей нейросетей 2026 года устроен сложнее, чем список громких названий: за каждым брендом скрывается несколько режимов, а победитель сравнения зависит от задачи, объёма и бюджета конкретного пользователя.
- Разница между моделью, сервисом и агентом принципиальна: модель — это движок, сервис — оболочка с интерфейсом и тарифом, агент — модель с ролью, инструментами и памятью для многошаговой работы.
- Текстовые модели различаются не абстрактным «умом», а конкретным сценарием: деловое письмо, длинный документ или сложное рассуждение требуют разных параметров контекста и скорости.
- Для кода и исследований обязательна проверка результата — тестами, статическим анализом и ссылками на источники, а не доверием к первому ответу.
- Визуальные и видео-модели оцениваются по композиции, стабильности деталей и количеству итераций, а не по одной удачной генерации.
- Музыкальные модели дают быстрый черновик идеи, но финальное сведение, структура и проверка лицензии остаются отдельными шагами.
- Агенты полезны там, где задачу можно разбить на этапы, но критичные действия всегда требуют подтверждения человека.
- Сравнение цен в таблице — стартовая точка, а не финальное решение: реальный тест на своей задаче всё равно обязателен.
- Доступность в России и контроль расходов — два разных вопроса, которые проверяются отдельно для каждого конкретного сервиса.
- Агрегатор вроде ModelStation снижает трение при тестировании нескольких моделей сразу, но не заменяет осознанный выбор под конкретную задачу.