Где искать все нейросети и почему одного списка недостаточно
Новые AI-сервисы выходят чаще, чем пользователь успевает разобраться, для чего они нужны, доступны ли они из России и сколько стоят. За неделю может появиться три генератора изображений и два новых текстовых чата — и ни один рейтинг не успевает за этим темпом. Поэтому запрос «все нейросети» не имеет смысла как ссылка на один официальный каталог: его физически не существует.
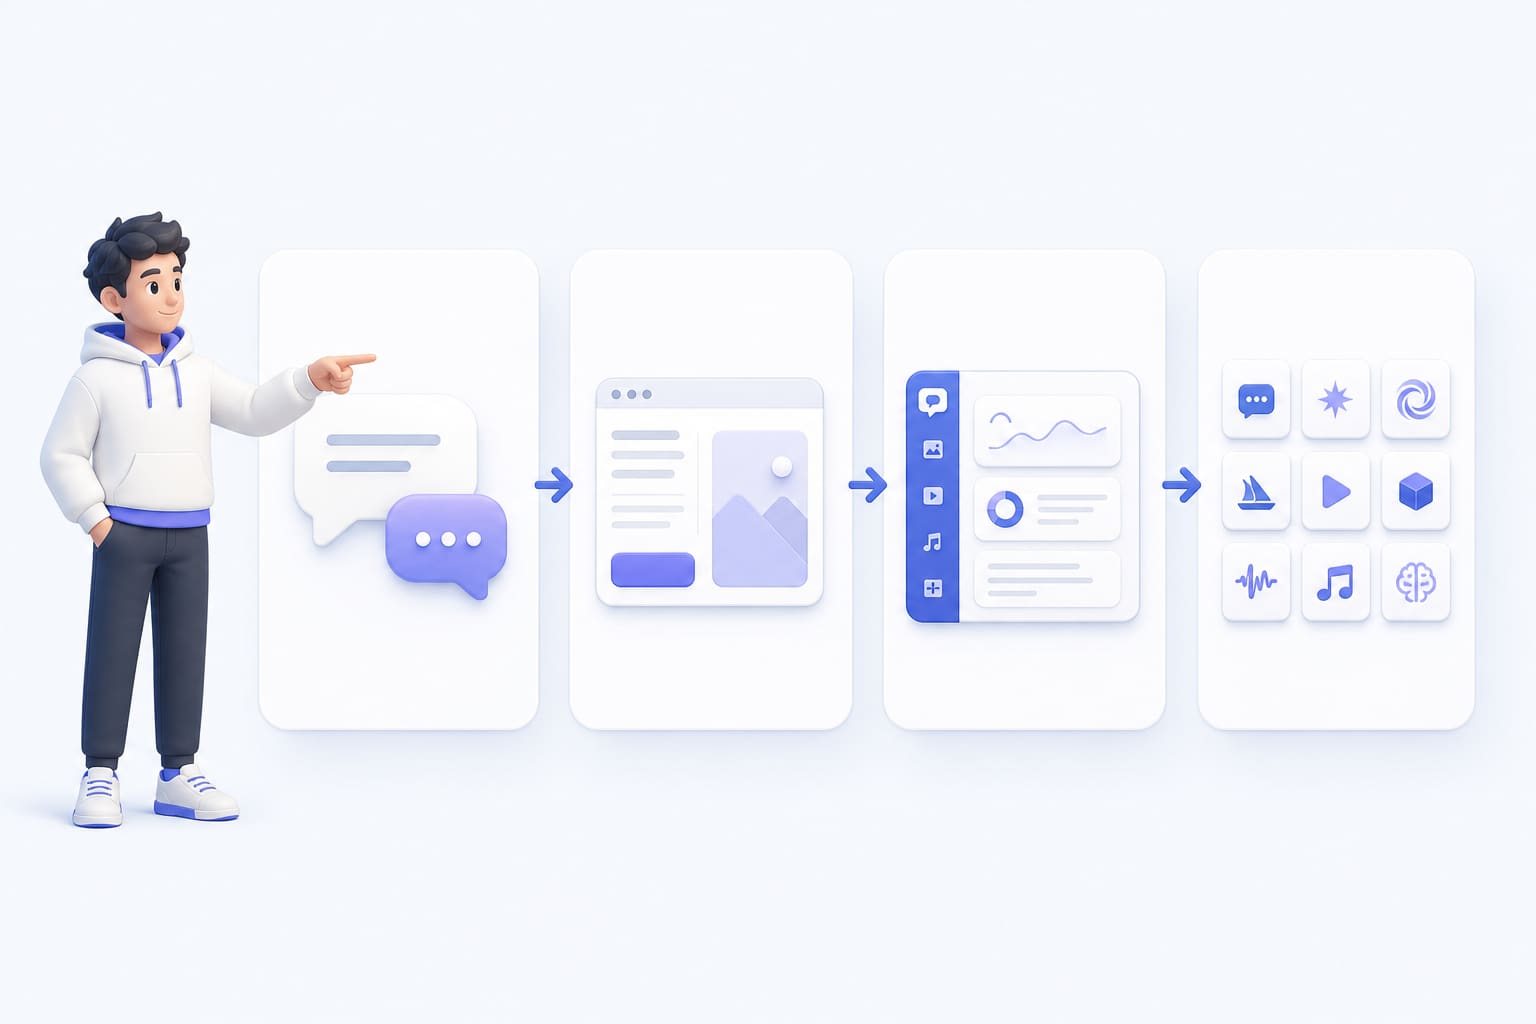
Рынок распадается на разные типы объектов, и их нельзя сравнивать напрямую. Есть отдельные модели — вроде GPT или Stable Diffusion, которые сами по себе не имеют интерфейса. Есть сервисы — готовые приложения с чатом, кнопками и подпиской, построенные поверх одной или нескольких моделей. Есть платформы — облачные среды, где модель доступна через API для встраивания в чужой продукт. И есть агрегаторы — рабочие пространства, где можно выбирать между моделями разных поставщиков без десятка отдельных регистраций.
Простой пример: одну и ту же языковую модель можно использовать через фирменный чат компании-разработчика, через прямой вызов API в собственном приложении, через стороннюю надстройку с дополнительными функциями или через единый агрегатор, где она стоит рядом с конкурентами. Результат генерации в этих четырёх случаях может отличаться — потому что отличаются системные инструкции, лимиты контекста и настройки температуры генерации.
Чтобы каталог был полезен, он должен отвечать на конкретные вопросы: какую задачу решает инструмент, какой формат у входа и выхода — текст, картинка, аудио или видео, доступен ли сервис из России без обхода блокировок, какой тариф и какие лимиты, что происходит с загруженными данными и насколько прилично модель работает с русским языком. Если список не даёт ответов на эти пункты, он бесполезен — даже если в нём двести названий.
Далее статья разбирает нейросети по категориям задач: тексты, изображения, видео, музыка и голос, отдельно — российские сервисы. В конце — рабочая методика сравнения и пошаговый сценарий, которые закрывают главный вопрос: как перейти от бесконечного поиска к выбору одного-двух инструментов под реальную задачу. Один из рабочих способов — сразу зайти в Все ТОП нейросети в одном пространстве — ModelStation, где собраны модели разных категорий без необходимости регистрироваться в каждом сервисе отдельно.
Как устроен рынок AI: модели, приложения, API и агрегаторы
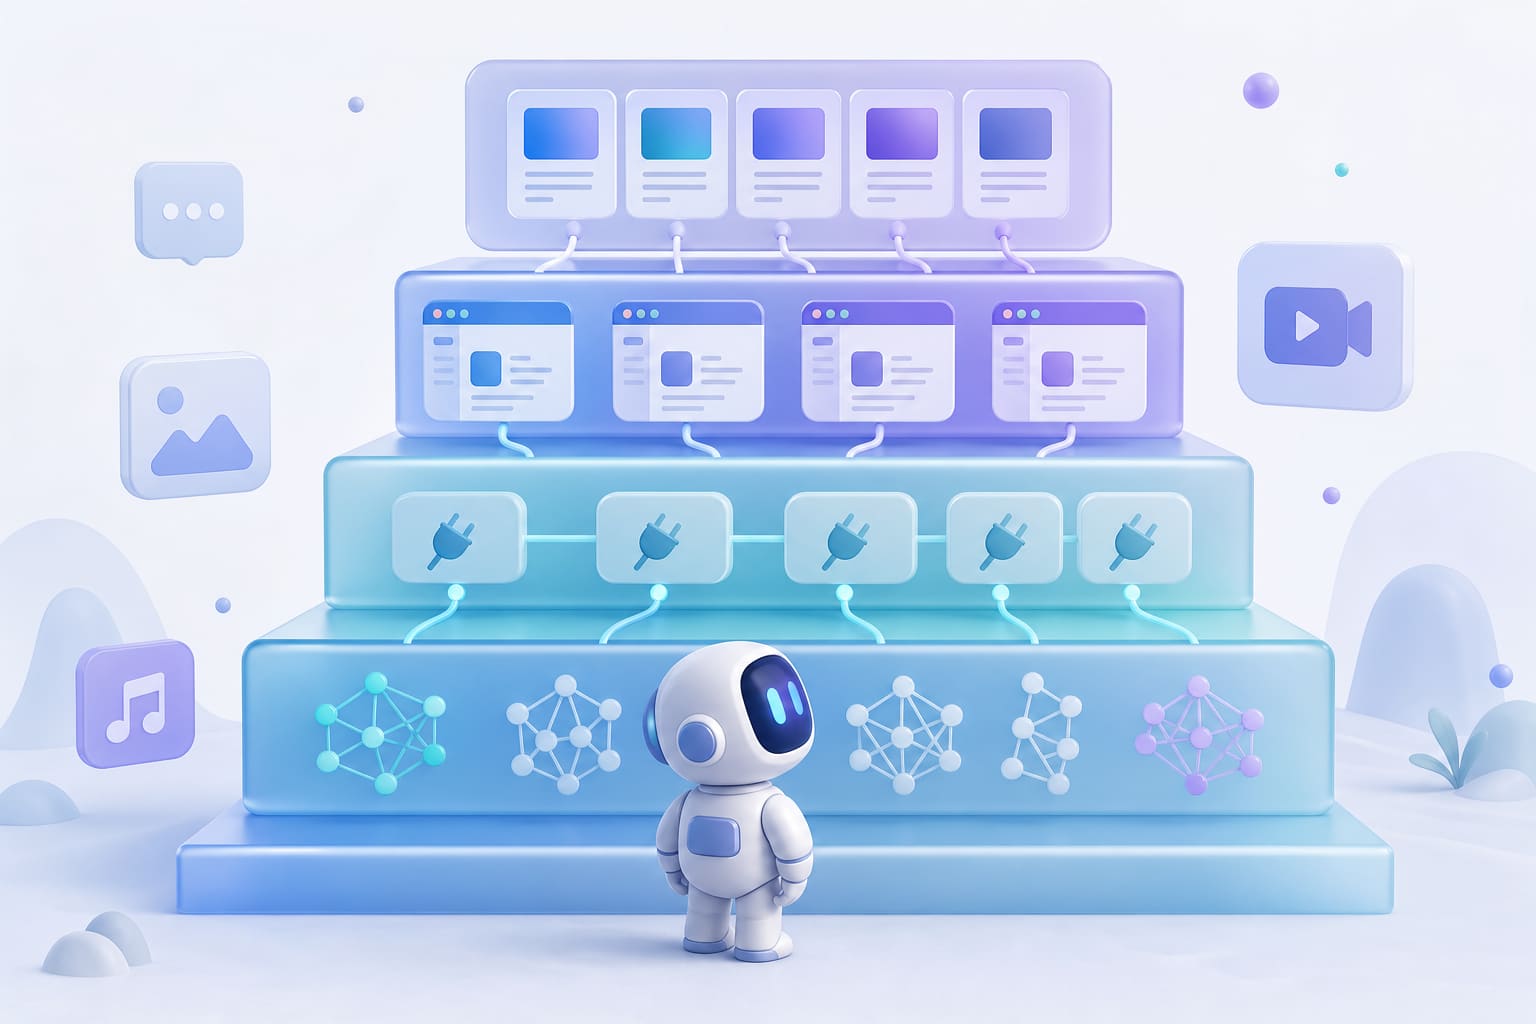
Рынок искусственного интеллекта держится на четырёх уровнях, и перепутав их, легко сравнить несравнимое. Первый уровень — базовые и специализированные модели: языковые для текста, визуальные для изображений, аудиомодели для речи и музыки, видеомодели и мультимодальные системы, которые принимают на входе сразу текст, картинку и звук.
Второй уровень — пользовательские приложения. Здесь модель уже обёрнута в интерфейс: добавлены редактор, память переписки, шаблоны промптов, поиск по интернету или загрузка файлов. Именно так большинство людей и встречает нейросети впервые — не как голую технологию, а как готовый продукт с кнопками.
Третий уровень — API и облачные среды. Через них компании подключают генерацию к своим продуктам: интернет-магазин получает автоматическое описание товара, CRM — суммаризацию звонков, конструктор сайтов — подбор текста для лендинга. Разработчик работает здесь не с готовым чатом, а с документацией, токенами и лимитами запросов в минуту.
Четвёртый уровень — агрегаторы, которые дают доступ к нескольким моделям из одного кабинета. Они удобны для тестирования: не нужно заводить пять аккаунтов, чтобы сравнить пять моделей на одной задаче. Но агрегатор не отменяет домашнюю работу — проверку лицензии на коммерческое использование результата, политику хранения данных и условия конкретного провайдера модели внутри агрегатора.
Важная деталь: название сервиса и название модели внутри него не всегда совпадают, а итоговое качество ответа зависит не только от бренда, но и от формулировки промпта, длины контекста, выбранного режима и параметров генерации — температуры, количества вариантов, разрешения. Редактору нужна скорость черновика, дизайнеру — контроль композиции, предпринимателю — автоматизация рутины, разработчику — стабильный API с понятной документацией вроде документации Google AI для разработчиков моделей.
Возражение «агрегатор скрывает реальные различия между моделями» не подтверждается на практике: наоборот, когда две модели отвечают на один и тот же запрос рядом, разница в стиле, длине и точности становится заметнее, чем при последовательном тестировании в разных вкладках. Разобраться, как выбрать лучшую AI-модель и не переплачивать, проще именно тогда, когда варианты видны одновременно, а не по памяти после переключения между сайтами.
Текстовые нейросети: чаты, поиск, документы и код
Текстовые инструменты стоит делить по сценарию, а не по узнаваемости бренда. Универсальный чат — для черновика письма, идеи заголовка, короткого плана — не требует глубокой настройки и прощает неточные формулировки запроса. Модель для анализа файлов и длинного контекста нужна, когда на вход идёт документ на двадцать страниц, договор или техническое задание: здесь важно не потерять деталь в середине текста. AI-поиск с источниками отличается тем, что отвечает со ссылками, а не выдаёт голый текст без возможности проверки. Инструменты программирования работают с кодом и объясняют логику ошибки, а корпоративные помощники встраиваются в почту, календарь и внутренние базы знаний.
Среди международных примеров к универсальным чатам относится ChatGPT, к длинному контексту и анализу файлов — Claude, к мультимодальным сценариям — Gemini, к рабочим сценариям внутри офисных программ — Microsoft Copilot, к AI-поиску с источниками — Perplexity. Ни один из них не выигрывает во всех задачах одновременно: Claude может держать более длинный документ без потери сути, а узкоспециализированный ассистент для кода точнее подсказывает синтаксис конкретного языка программирования.
При выборе текстового инструмента стоит проверить шесть пунктов: качество русского языка на реальном примере, а не на английском демо; максимальную длину контекста в токенах; умеет ли модель читать загруженные файлы — PDF, таблицы, презентации; есть ли встроенный веб-поиск с указанием источника; можно ли экспортировать результат в нужном формате; какие ограничения действуют на бесплатном тарифе и что сервис делает с введёнными данными.
Оценивать ответ нужно на конкретном примере, а не на общем впечатлении: деловое письмо клиенту, техническое задание для подрядчика, сжатая сводка двадцатистраничного отчёта, SQL-запрос с условием по дате или фрагмент кода с обработкой исключения. Сравнение на одном и том же примере в двух моделях быстро показывает разницу в точности и стиле.
Языковая модель не источник истины: она может уверенно привести несуществующую статистику или устаревшую цифру. Любой факт, который пойдёт в публичный материал или договор, проверяется отдельно — по первоисточнику, а не по убедительности формулировки. Подробный разбор инструментов собран в материале «Нейросети для текста: рейтинг 10 генераторов онлайн», где классификация построена именно по сценарию использования, а не по популярности бренда. Дополнительный ориентир по работе с AI-поиском и ответами со ссылками — платформа Perplexity, а для рабочих сценариев внутри офисных пакетов полезно изучить Microsoft Copilot.
Нейросети для изображений и дизайна
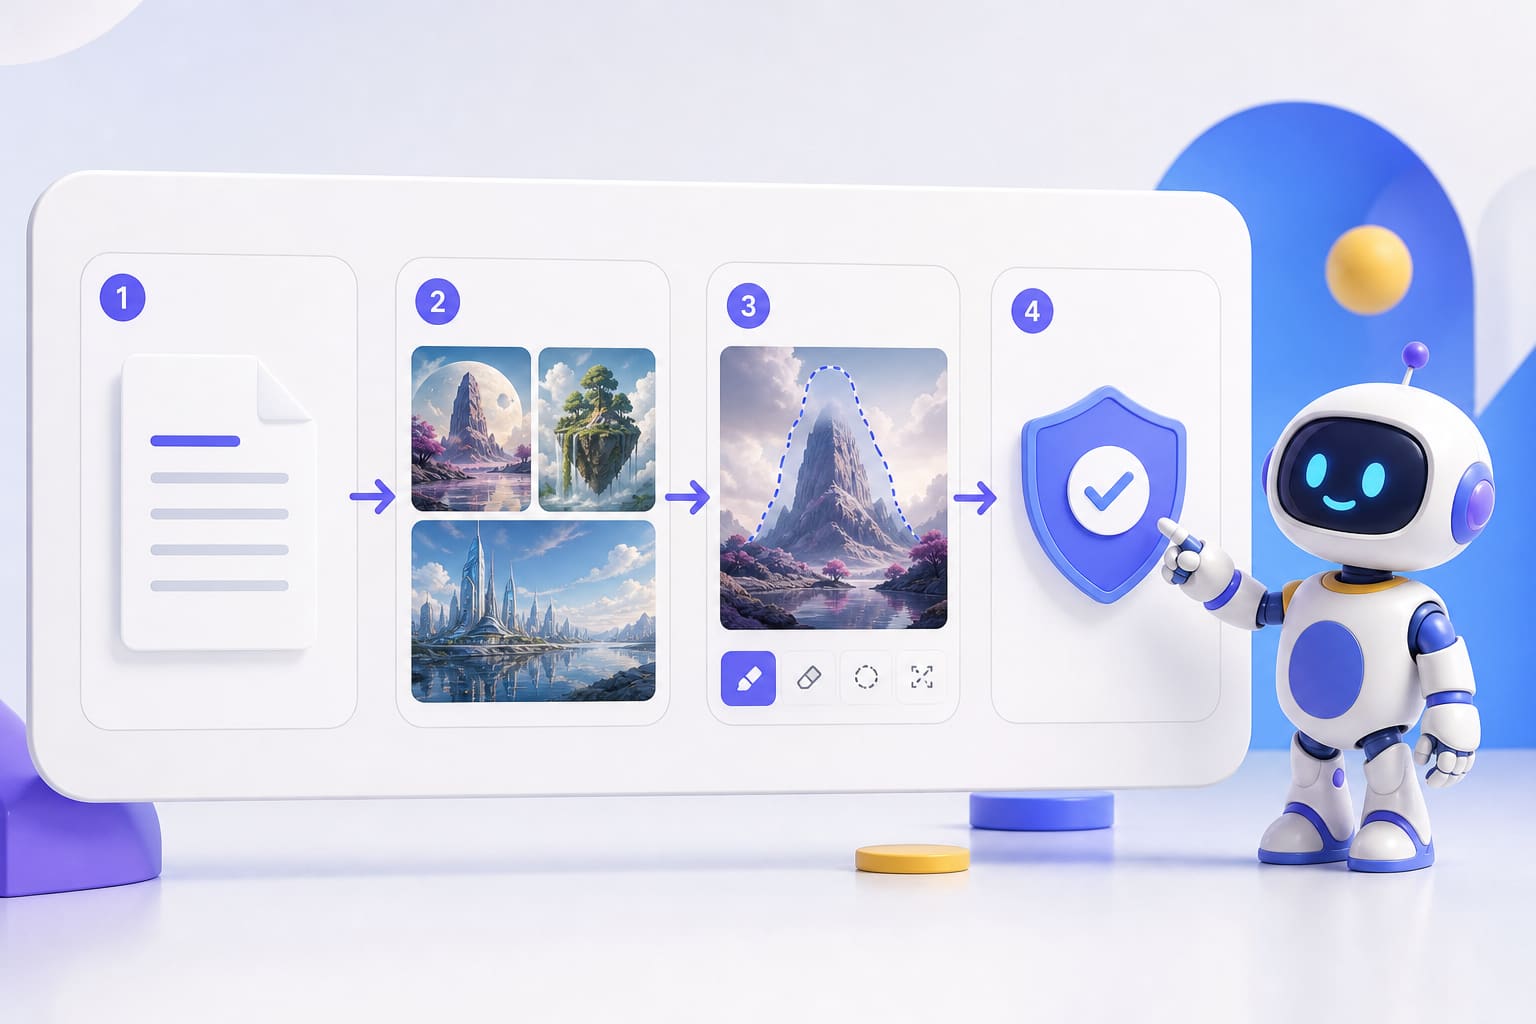
Генерация изображений закрывает разные задачи: концепт для презентации, иллюстрация к статье, рекламный макет, товарная фотография для карточки на маркетплейсе, удаление фона, правка отдельного объекта на снимке, увеличение разрешения и подбор нескольких вариантов одной идеи. Универсальный генератор хорош для быстрого концепта, а инструмент для дизайна нужен там, где важен контроль композиции, точные размеры под рекламный баннер, читаемый текст на макете и соответствие брендовым цветам.
Среди международных примеров к универсальным и коммерчески безопасным решениям относится Adobe Firefly, к открытым моделям с широкими настройками — Stable Diffusion от Stability AI. В российском контексте доступны локальные решения и агрегаторы вроде ModelStation, где можно получить изображение без привязки к одному конкретному поставщику модели.
Ограничения здесь конкретные, а не абстрактные. Надписи и текст внутри сгенерированного изображения искажаются чаще, чем остальная картинка — особенно кириллица на мелком шрифте. Лица и кисти рук требуют отдельной проверки: лишний палец или асимметрия черт — частая проблема генераторов. Коммерческая лицензия не одинакова у всех сервисов: одни разрешают продавать результат без ограничений, другие требуют платную подписку именно для коммерческого использования. Загружать исходные фотографии людей или брендовые материалы без оценки политики хранения не стоит — часть сервисов сохраняет загруженные файлы для обучения модели.
Рабочая последовательность выглядит так: сформулировать задачу в одном предложении с указанием стиля и формата, выбрать подходящий режим — генерация с нуля, редактирование существующего фото или увеличение разрешения, получить три-четыре варианта вместо одного, проверить композицию и мелкие детали, затем доработать промпт или вручную поправить итог в редакторе. Практические примеры запросов и результатов собраны в материале «Как использовать нейросети для генерации фото и картинок», а готовые инструменты для редактирования доступны в разделе «Изображения, которые работают на вашу идею». Для сравнения платформ нейросетей в части изображений полезно также посмотреть официальную страницу Adobe Firefly и разработчика открытых моделей Stability AI.
Видео, анимация и монтаж с помощью AI
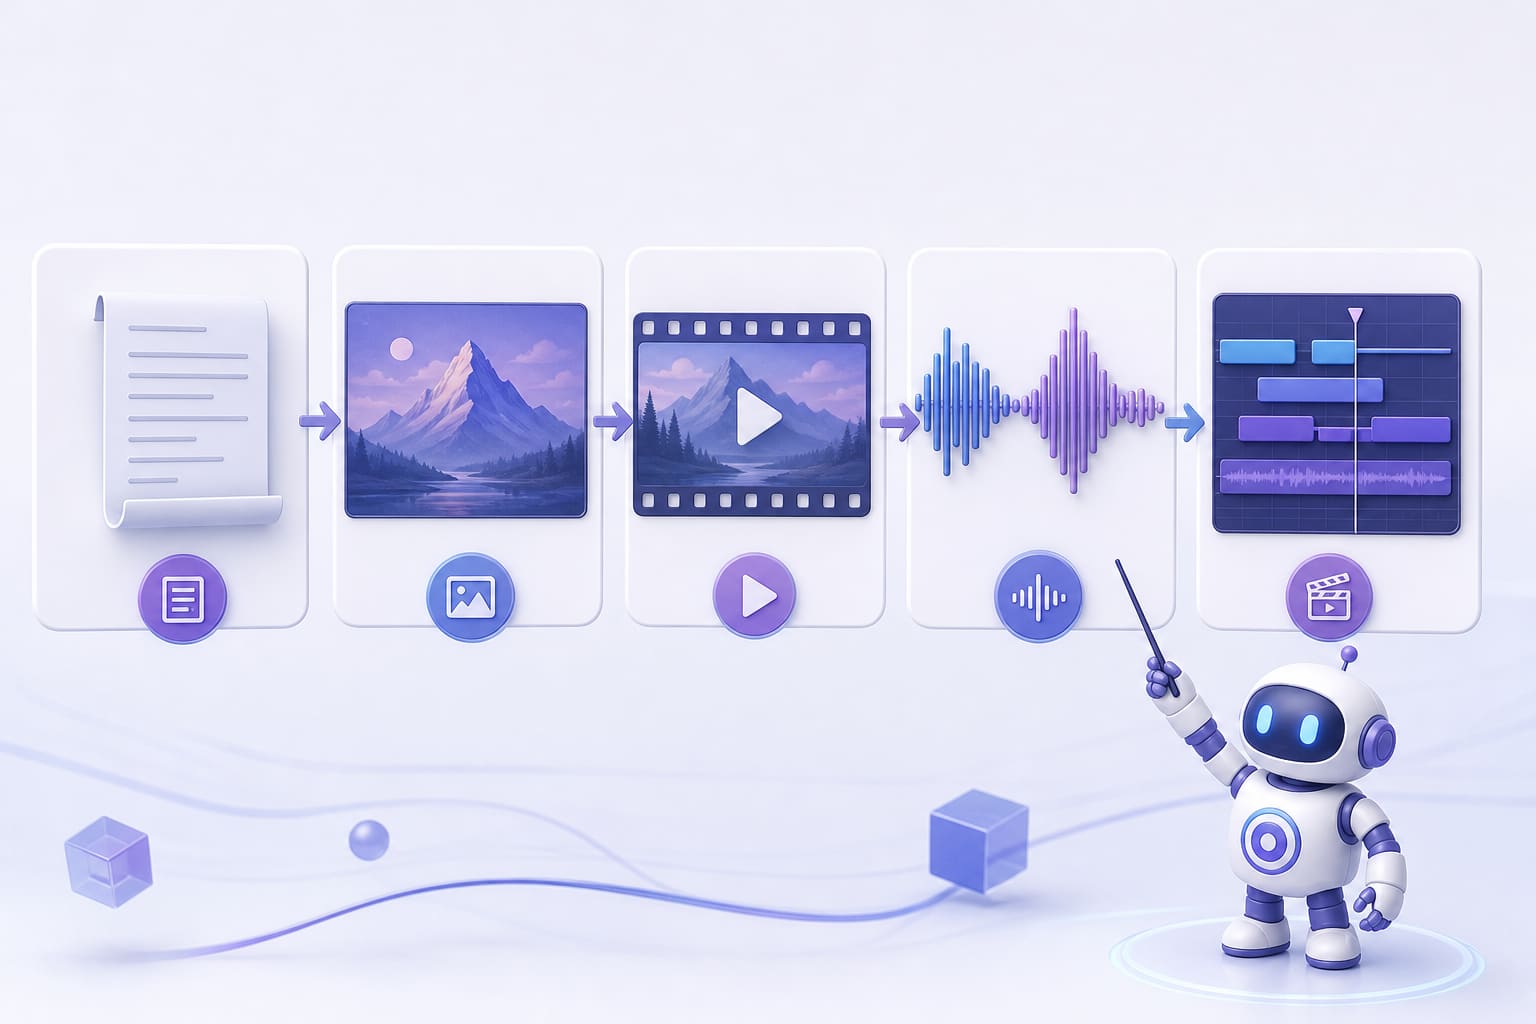
Видеоинструменты различаются по тому, что подаётся на вход и насколько управляем результат. Текст в видео — модель рисует ролик по текстовому описанию. Изображение в видео — статичная картинка оживает и получает небольшое движение. Продолжение ролика — модель достраивает следующую сцену по уже существующему клипу. Есть отдельные режимы замены объектов в кадре, монтажа нескольких сцен, синхронизации губ персонажа с озвучкой и сборки короткого рекламного формата.
Из международных решений заметен Runway — один из первых сервисов, предложивших генерацию и редактирование видео в едином интерфейсе. Рядом существуют российские сервисы и агрегаторы, доступные пользователю из Москвы и Санкт-Петербурга без обхода ограничений.
Практические ограничения конкретны: клип редко длится дольше нескольких секунд за одну генерацию, персонаж может менять черты лица между соседними сценами, движение иногда выглядит с артефактами — особенно руки и мелкие предметы, разрешение итогового видео часто ниже заявленного в демо-роликах, часть бесплатных тарифов добавляет водяной знак, а генерации тарифицируются отдельно от обычной подписки — по количеству секунд или кадров.
Для маркетолога рабочий порядок такой: сначала сценарий и раскадровка по сценам на бумаге или в заметках, затем ключевой кадр для каждой сцены, короткие сгенерированные фрагменты по пять-десять секунд, отдельная озвучка текста синтезом речи и финальная сборка в видеоредакторе. Не стоит выбирать инструмент только по красивому демонстрационному ролику на сайте разработчика — там обычно показан лучший из сотен сгенерированных вариантов, а не типичный результат с первой попытки.
Удобнее всего сравнивать несколько видеомоделей на одинаковом запросе в едином интерфейсе — так видно разницу в стабильности персонажа и качестве движения без необходимости заводить отдельный аккаунт под каждый сервис. Примеры и разбор форматов собраны в материале «Как использовать нейросети для создания ИИ-видео». Из официальных источников стоит изучить страницу Runway и функцию AI-видеогенерации Adobe.
Музыка, песни, голос и звуковой контент
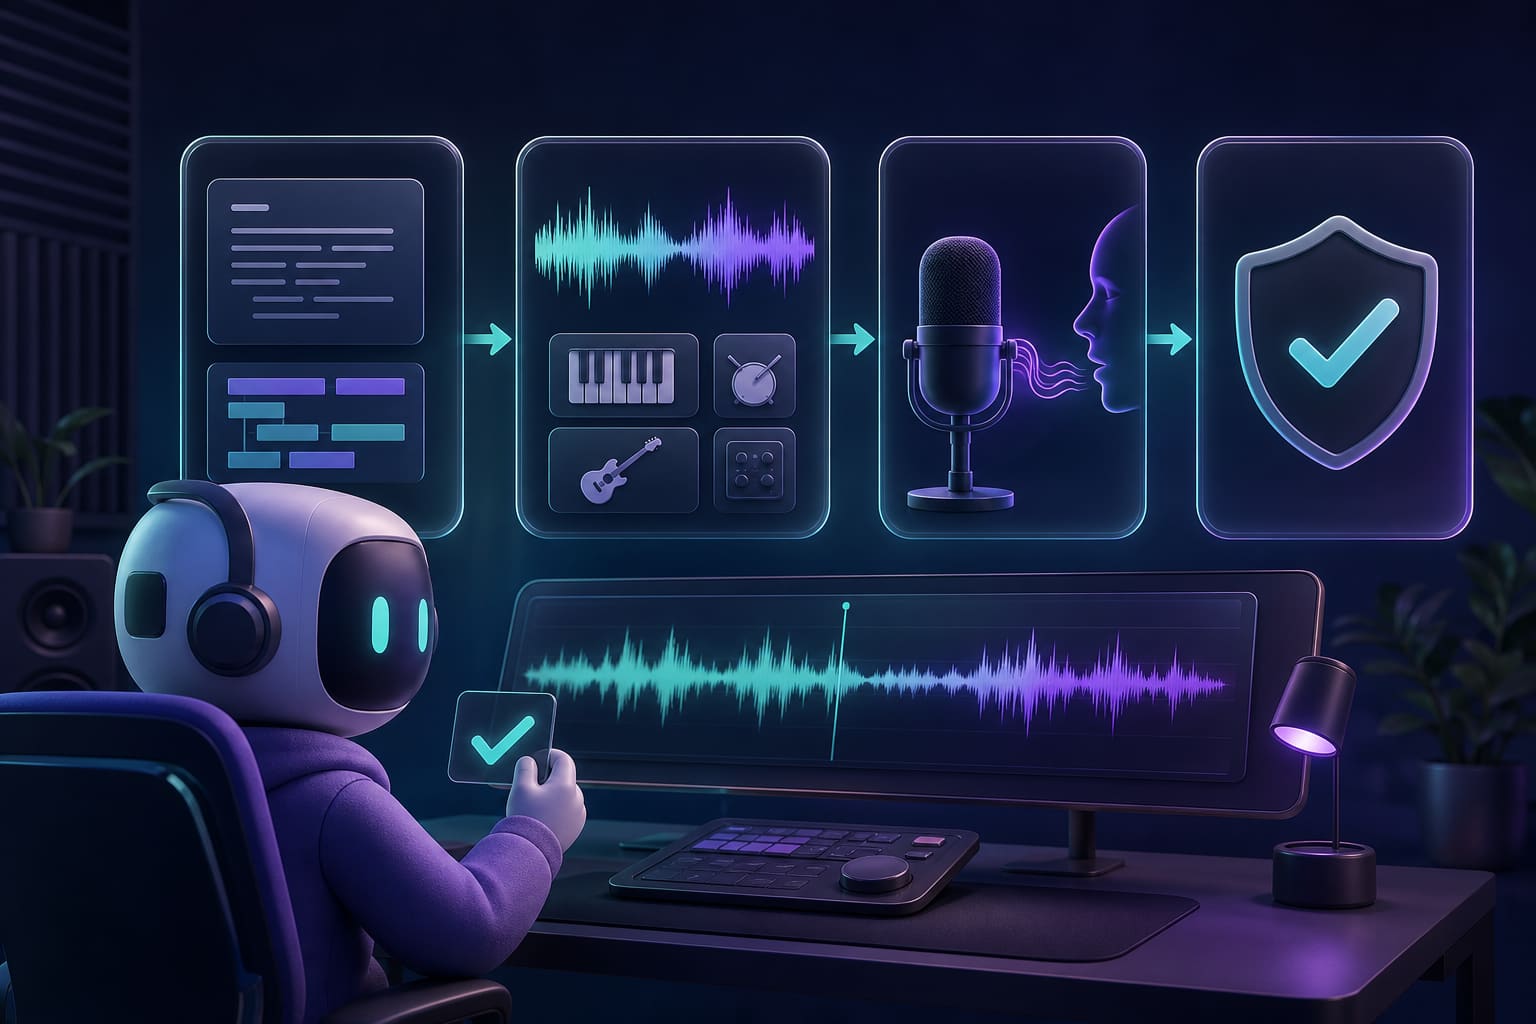
Аудиоинструменты делятся на шесть направлений: генерация фоновой музыки без слов, создание песни целиком по текстовому описанию стиля и настроения, синтез речи по тексту, клонирование конкретного голоса, очистка записи от шума и саунд-дизайн для видео и игр. Это разные задачи с разными требованиями к исходным данным.
Suno известен генерацией песен с вокалом по короткому описанию жанра и темы, ElevenLabs — синтезом и клонированием голоса с естественной интонацией. Перед коммерческим использованием результата обязательно смотреть права: условия отличаются у разных сервисов, а клонирование чужого голоса без согласия — отдельный юридический риск независимо от того, насколько качественно получилась имитация.
Для русскоязычного пользователя критичны произношение, корректная постановка ударений, естественность интонации на длинных фразах и честная поддержка кириллицы — часть моделей обучена преимущественно на английской речи и «спотыкается» на русских именах собственных и аббревиатурах.
Сценарий для автора контента: сначала текст песни со структурой куплет-припев-куплет, затем описание музыкального настроения — темп, жанр, инструменты, после этого несколько генераций подряд, отбор лучшего варианта, точечная доработка промпта под слабые места и обязательная проверка лицензии перед публикацией или продажей. Для бизнеса добавляется озвучка рекламных роликов, запись голосовых сценариев для телефонии и начитка обучающих материалов — это экономит время диктора при частых правках текста.
Музыкальные нейросети нужны не только музыкантам: подкастер использует синтез голоса для быстрой озвучки интро, маркетолог — для рекламного ролика без студии, автор презентаций — для короткого музыкального фона без риска нарушить авторские права на чужой трек. Инструменты для музыки и песен собраны в разделе «Музыка/Песни», а подробный разбор процесса создания — в материале «Генерация музыки и песен с помощью искусственного интеллекта». Официальные страницы Suno и ElevenLabs содержат актуальные условия использования голоса и музыки.
Российские AI-сервисы и все нейросети рф
Российский контур рынка не нужно противопоставлять зарубежному — задача не выбрать победителя, а понять, что доступно и подходит ли это под конкретную работу. GigaChat и YandexGPT ориентированы на русский язык, локальные сценарии и интеграцию с российской инфраструктурой — от документооборота до корпоративных чат-ботов.
Доступность из России не равна автоматическому превосходству в качестве. Решение нужно проверять на собственной задаче: один сервис лучше пишет деловые письма, другой точнее работает с юридическими формулировками, а условия API, лимиты запросов и тарифы периодически меняются у всех провайдеров без исключения.
Критерии проверки российского сервиса: регистрация доступна из России без VPN, оплата проходит в рублях, понятны условия обработки персональных данных, есть документированный API для интеграции, поддерживается загрузка документов, приемлема скорость ответа, достаточен размер контекстного окна, есть ли мультимодальность — работа с изображениями и голосом, и можно ли экспортировать результат в нужном формате.
Запрос «все нейросети рф» не стоит понимать как ссылку на исчерпывающий государственный реестр — такого реестра нет. Это пользовательская задача: найти заметные локальные решения и сопоставить их с международными аналогами по тем же критериям — язык, цена, лимиты, приватность. Для бизнеса с требованиями к хранению данных внутри страны российские сервисы часто становятся обязательным, а не опциональным выбором. Для частного пользователя, которому важна только скорость и качество ответа, выбор шире и может включать международные сервисы наравне с локальными. Подробнее о бесплатном доступе к русскоязычным инструментам — в материале «Русскоязычные ИИ-сервисы: как пользоваться бесплатно». Технические детали подключения можно свериться с документацией GigaChat API и страницей YandexGPT в Yandex Cloud.
Как сравнить AI-инструменты по задачам и качеству результата
Честное сравнение строится на одном правиле: одинаковая задача и одинаковый вход для всех участников теста. Это означает один и тот же промпт, один и тот же файл, одно и то же исходное изображение, одинаковая длительность ролика или одинаковый текст песни — без вариаций формулировки между моделями.
Оценивать нужно не только первый эффектный результат, а шесть параметров сразу: точность — соответствие факту или задаче, стабильность при повторном запуске того же промпта, скорость генерации, управляемость через настройки и параметры, качество русского языка и возможность экспортировать результат в рабочем формате, а также итоговую стоимость одной генерации.
Простая рабочая шкала для сравнения платформ нейросетей включает шесть пунктов: качество результата, удобство интерфейса, лимиты использования, цена за единицу генерации, политика приватности данных и реальная доступность сервиса из России без дополнительных ухищрений.
Универсального победителя не существует: одна модель пишет живее и образнее, другая держит более длинный документ без потери сути, третья стабильнее создаёт изображения с читаемым текстом, четвёртая выигрывает по скорости ответа или цене за запрос. Выбор зависит от задачи, а не от общего рейтинга в интернете.
Результаты тестов стоит фиксировать в таблице с колонками «модель», «время ответа», «оценка по пятибалльной шкале», «стоимость» и «замечания» — и не менять критерии оценки после того, как одна из моделей случайно выдала особенно удачный пример. Рейтинг в интернете полезен как стартовая навигация — он помогает сузить список из полусотни вариантов до пяти-семи кандидатов, но не заменяет собственный тест на реальной задаче. Инструмент для такого сравнения — раздел «Какие нейросети лучшие для текста, генерации фото, видео и музыки», где можно быстро проверить несколько моделей без переключения между вкладками. Техническую сторону единого доступа к нескольким моделям показывает документация OpenRouter, а принцип фильтрации по задаче — каталог моделей с фильтрами.
Когда нужен агрегатор нейросетей вместо отдельных аккаунтов
Пользователь, который держит пять-шесть подписок на разные AI-сервисы, теряет время не на саму генерацию, а на организацию работы вокруг неё: десятки открытых вкладок, разные формы оплаты, отдельные лимиты у каждого сервиса, повторная загрузка одного и того же файла в три разных интерфейса и невозможность быстро вспомнить, какая именно модель дала лучший результат неделю назад.
Единый интерфейс особенно полезен в четырёх ситуациях: быстрые эксперименты с формулировкой промпта, когда нужно протестировать идею сразу на нескольких моделях; производство контента разных форматов в рамках одной задачи — текст, обложка, короткое видео и фоновая музыка для одного поста; системное тестирование моделей перед выбором постоянного инструмента; совместная работа команды с общей историей запросов и контролем расходов на одном балансе.
У агрегатора есть и ограничения. Набор доступных моделей не бесконечен и зависит от соглашений с провайдерами. Интерфейс агрегатора может отличаться от оригинального сервиса — часть тонких настроек бывает скрыта. Доступность конкретной модели зависит от политики её владельца и может меняться без предупреждения. Приватность данных и права на сгенерированный результат всё равно нужно проверять — агрегатор не отменяет это требование, а лишь даёт единую точку входа.
В ModelStation собраны AI-чаты, генерация и редактирование изображений, видео, музыка и песни, AI-агенты для повторяющихся операций, память контекста между сессиями, сравнение ответов нескольких моделей на один запрос и оплата по факту фактического использования без обязательной постоянной подписки.
Агрегатор нужен не только новичку, который боится разбираться в пяти разных интерфейсах. Он полезен и специалисту, который регулярно выбирает модель под конкретное сочетание стоимости, качества и скорости — и которому важно не тратить время на переключение между отдельными кабинетами. Больше о логике платформы — в разделе «О ModelStation», а практические разборы моделей, памяти и агентов собраны в блоге ModelStation. Похожий принцип единого доступа к поиску и AI-функциям реализован в платформе Perplexity.
Тарифы, лимиты и контроль расходов на AI
Финансовая сторона выбора складывается из нескольких форматов оплаты: бесплатный доступ с ограничением по числу запросов в день, помесячная подписка с фиксированной ценой, оплата за отдельный запрос, система токенов или кредитов, списываемых за объём сгенерированного текста или изображения, лимит по скорости обращений в минуту и отдельная тарификация за изображения, видео или аудио — эти форматы обычно стоят дороже текстовых запросов.
Низкая цена за запрос не всегда означает реальную выгоду. Важны длина доступного контекста — короткий лимит заставляет разбивать документ на части и терять целостность, количество итераций до приемлемого результата, стоимость повторных генераций при неудачном первом варианте, возможность экспорта в нужном качестве без дополнительной платы и собственное время специалиста, которое уходит на подгонку результата под формат.
Предварительную оценку бюджета можно сделать простой формулой: число задач в месяц умножить на среднюю стоимость одной генерации, а затем добавить резерв примерно в треть суммы на неудачные попытки и повторные запуски — первая генерация редко оказывается финальной.
Логика нескольких отдельных подписок и логика оплаты по факту использования через агрегатор решают разные задачи. Подписка выгоднее при стабильно высокой нагрузке на один и тот же сервис, оплата по факту — при нерегулярном использовании нескольких разных моделей, когда содержать пять активных подписок одновременно нецелесообразно.
Актуальные тарифы и лимиты у любого провайдера меняются без предупреждения, поэтому вместо фиксированной суммы в статье разумнее сверяться с официальной страницей тарифов перед принятием решения — например, с тарифами GigaChat API. У ModelStation действует тариф с оплатой по факту использования: пользователь сам выбирает подходящий формат оплаты и контролирует расход по фактическим обращениям к моделям, без обещаний заранее посчитанной экономии.
Как выбрать нейросеть для бизнеса, контента и повседневных задач
Практический выбор удобно строить по трём группам пользователей с разными приоритетами. Создателю контента важны быстрые итерации текста, изображений, видео и музыки, единое хранение результатов проекта и возможность сравнить несколько вариантов перед публикацией. Два рабочих сценария для этой группы: подготовка рекламного поста вместе с визуалом за один заход и сборка короткого видео с озвучкой под один и тот же бриф.
Специалисту или предпринимателю важнее автоматизация рутинных операций, работа с документами, AI-агенты для повторяющихся задач, интеграции с внутренними системами, требования безопасности и контроль расходов на всю команду, а не только на себя. Сценарии здесь — сводка длинного документа с выделением ключевых пунктов и письма и быстрый план деловой поездки с учётом бюджета и дат.
Пользователю с разовой задачей нужны понятный интерфейс без обучения, приличный русский язык, предсказуемый результат с первой-второй попытки и отсутствие лишней регистрации ради одной генерации. Для этой группы подходящие сценарии — быстрая обработка личной фотографии перед публикацией и короткий текст поздравления или объявления.
До запуска любой задачи полезно сформулировать критерий успеха: это экономия времени относительно ручной работы, итоговое качество без доработки, допустимое число правок или предельная стоимость готового материала. Без заранее заданного критерия сложно понять, оправдал ли инструмент ожидания.
Отдельно стоит предупредить: медицинские, юридические, финансовые и кадровые решения нельзя полностью передавать модели без проверки квалифицированным специалистом — языковая модель не несёт ответственности за последствия и может выдать правдоподобно звучащую, но ошибочную рекомендацию. Повторяющиеся операции внутри бизнеса удобно автоматизировать через раздел «AI-агенты ModelStation», а интеграцию AI в рабочие документы иллюстрирует Microsoft Copilot.
Безопасность, приватность и права на результат
Есть категории данных, которые не стоит отправлять в AI-сервис без явного основания: персональные данные клиентов, внутренние коммерческие документы, исходный код с секретными ключами, медицинскую информацию, непубличные договоры и чужие фотографии без согласия на их использование.
Риска фактически три, и они разные по природе. Первый — содержание запроса может сохраниться в истории аккаунта сервиса и остаться там дольше, чем предполагал пользователь. Второй — сгенерированный результат может содержать фактическую ошибку или заимствованный элемент, похожий на чужую работу. Третий — права на созданный текст, изображение или музыку зависят от условий конкретной платформы и применимой юрисдикции, а не являются универсальными для всех сервисов одинаково.
Короткий протокол безопасной работы выглядит так: удалить из запроса идентификаторы реальных людей и компаний, заменить конфиденциальные значения на условные перед отправкой в модель, проверить настройки хранения истории в конкретном сервисе, ограничить доступ команды к общему рабочему пространству ролями, сохранить исходные файлы отдельно от результата генерации и зафиксировать, какой моделью и промптом получен итоговый материал — на случай будущей проверки.
Для бизнеса протокол расширяется: роли доступа с разными правами для разных сотрудников, журналирование запросов для последующего аудита, хранение API-ключей вне общего репозитория кода и обязательное согласование публичной публикации сгенерированного материала с ответственным лицом перед выпуском.
Подход должен быть пропорциональным, а не запретительным: для идеи рекламного слогана риск минимальный и проверка нужна формальная, а для клиентской базы или договора риск совсем другого порядка и требует отдельного решения о допустимости использования внешнего AI-сервиса вообще. Подробный разбор критериев выбора безопасного инструмента — в материале «Все про нейросети: как выбрать ИИ-инструмент онлайн». Официальные формулировки политики обработки данных можно свериться на страницах политики конфиденциальности OpenAI и политики конфиденциальности Anthropic.
Пошаговый сценарий: от задачи до результата через ModelStation
Маршрут из пяти шагов можно повторить на любой задаче, не утопая в настройках. Шаг первый — описать результат и ограничения: формат материала, целевая аудитория, язык, срок готовности, стиль подачи и бюджет на генерацию. Это занимает пару минут, но экономит часы переделок.
Шаг второй — выбрать тип инструмента под задачу: текстовый чат для структуры и черновика, генератор изображений для визуала, видеомодель для ролика, музыкальный инструмент для фона, AI-агент для повторяющейся операции или комбинация нескольких типов в одном проекте.
Шаг третий — если нужно сравнение, запустить один и тот же запрос сразу в нескольких моделях вместо последовательного тестирования по очереди. Так заметнее разница в стиле и точности ответа.
Шаг четвёртый — оценить полученные варианты по заранее заданным критериям из раздела о сравнении, сохранить удачную версию отдельно и доработать формулировку промпта для следующей попытки, если результат не дотянул до нужного уровня.
Шаг пятый — проверить факты в тексте, права на использование изображения или музыки, конфиденциальность исходных данных и возможность экспортировать результат в нужном для публикации формате.
На примере контент-плана для недели цепочка выглядит так: текстовая модель собирает структуру из пяти постов с заголовками, визуальная модель создаёт обложку под каждый пост по единому стилю, видеомодель собирает короткий пятнадцатисекундный тизер для одной из публикаций, музыкальная модель подбирает фон без лицензионных рисков, а AI-агент автоматически собирает черновики в один календарь публикаций вместо ручного копирования.
Память контекста в ModelStation позволяет не повторять описание проекта в каждом новом запросе — модель помнит предыдущие сообщения сессии, а оплата по факту использования означает, что за тестовую неделю из пяти постов платится ровно столько, сколько было реально сгенерировано, без обязательной месячной подписки наперёд. Такой маршрут снимает главное возражение «слишком много настроек»: в нём ровно пять понятных шагов, и каждый выполняется один раз. Технический принцип единого доступа к разным моделям через одну точку входа показывает документация OpenRouter.
Что не стоит поручать нейросетям без проверки
Есть пять операций, которые нельзя принимать от модели без контроля человека: медицинские, юридические, финансовые и кадровые решения; публикация непроверенных фактов и статистики; использование чужого голоса, фотографии или бренда без разрешения; передача моделям коммерческих секретов и персональных данных; и восприятие первого сгенерированного варианта как готового коммерческого материала без доработки.
Типичные ошибки встречаются регулярно и у разных сервисов одинаково: уверенный вымысел фактов, которых не существует; устаревшая информация, не отражающая текущую ситуацию; неверные расчёты в числовых примерах; нарушение заданного тона — слишком формально там, где нужна лёгкость, или наоборот; плохая кириллица на сгенерированном изображении; нестабильность внешности персонажа между сценами видео; и неочевидные ограничения лицензии, которые всплывают только при внимательном чтении условий сервиса.
Для каждого риска есть конкретный способ контроля. Факт проверяется по первоисточнику, а не по уверенности формулировки модели. Юридически или медицински значимый текст проходит экспертную проверку специалистом до публикации. Качество стабильно оценивается на одном и том же тестовом наборе запросов, а не на случайных примерах. Публичный текст проходит ручную вычитку перед выходом. Права на использование изображения, музыки или голоса согласуются отдельно от факта генерации. А журнал изменений фиксирует, какой версией промпта и какой моделью получен итоговый материал — это упрощает разбор, если позже найдётся ошибка.
Нейросеть ускоряет работу в разы, но ответственность за итоговый результат — за точность, законность использования и соответствие фактам — остаётся у человека или организации, которая его публикует. Основа для системной проверки рисков AI описана в NIST AI Risk Management Framework — это удобный первоисточник для построения внутреннего протокола проверки.
Итоговый выбор: каталог, отдельный сервис или агрегатор
Финальная логика выбора складывается из трёх условий, а не из одного универсального совета. Если задача узкая и повторяется ежедневно — например, одна и та же озвучка роликов для одного проекта — разумно выбрать специализированный сервис под эту конкретную операцию и не распылять усилия на тестирование альтернатив.
Если нужно исследование темы, тестирование нескольких моделей подряд или производство разных форматов контента в рамках одного проекта — текст, картинка, видео и музыка одновременно, — удобнее агрегатор: он экономит время на организации, а не на самой генерации.
Если критичны локальная инфраструктура, оплата в рублях и качество русского языка в узкоспециализированных сценариях — стоит отдельно рассматривать российские решения вроде GigaChat и YandexGPT и проверять их на собственном наборе задач, а не полагаться на общие описания с сайта разработчика.
Новичку лучше начать с одного понятного сценария — например, с генерации текста для одного типа задач — и не подключать сразу десяток инструментов параллельно: это распыляет внимание и усложняет сравнение результатов. Команде, наоборот, стоит с самого начала зафиксировать критерии выбора модели, права доступа сотрудников, лимиты расходов на месяц и процесс проверки сгенерированного материала перед публикацией.
Практический итог: все нейросети не умещаются в один список, но их можно систематизировать по задаче, формату и доступности. Сравнение платформ нейросетей имеет смысл только на одинаковом входе и с заранее заданными критериями — иначе оценка превращается в субъективное впечатление от первого удачного примера. Там, где нужно общаться с текстовыми моделями, создавать изображения, видео и музыку, использовать AI-агентов, сохранять контекст диалога и сравнивать ответы нескольких моделей без переключения между вкладками, удобно начать с тарифа ModelStation и оплаты по факту фактического использования. Отдельные специализированные сервисы вроде Claude или Gemini остаются хорошим вариантом, когда задача узкая и понятная заранее.
Частые вопросы
H3: Чем каталог отличается от агрегатора нейросетей
Каталог помогает обнаружить сервис: он показывает название, краткое описание и ссылку на сайт разработчика, но не даёт рабочего доступа к модели. Агрегатор идёт дальше — внутри него можно сразу отправить запрос и получить результат от нескольких моделей, не переходя на внешние сайты.
Разница заметна по семи пунктам: регистрация — у каталога не нужна вовсе, у агрегатора одна вместо нескольких; история диалогов — сохраняется только в агрегаторе; оплата — единая вместо нескольких отдельных подписок; сравнение ответов — доступно только в агрегаторе; загрузка файлов — работает напрямую в рабочем пространстве; память контекста — переносится между запросами внутри сессии; автоматизация через агентов — тоже функция агрегатора, а не справочного списка. Пример: ищущий инструмент для текста и изображения в каталоге получит две ссылки на разные сайты, а в агрегаторе — доступ к обеим задачам из одного окна.